بلاگ
تأثیرات طرحهای تشخیص خطا بر قابلیت اطمینان سیستم توزیع
- چکیده
- کلمات کلیدی
- I. نامگذاری
- II. مقدمه
- روش ارزیابی قابلیت اطمینان
- نتایج مطالعات
- مطالعات موردی: تأثیر طرحهای تشخیص خطا بر قابلیت اطمینان
- مورد ۱: حالت پایه (بدون سیستم خودکار تشخیص خطا)
- جدول I – دادههای پایه سیستم آزمایشی
- مورد ۲: با پیادهسازی سیستم تشخیص خطا مبتنی بر پاسخ به خطا (RFDS)
- مورد ۳: با پیادهسازی سیستم تشخیص خطا مبتنی بر پایش پیشفعال (PFDS)
- جدول II – دادههای پایه برای انجام تحلیل FMA در هر مطالعه موردی
- دادههای پایه و فرضیات تحلیل
- نتایج شاخصهای قابلیت اطمینان
- تأثیرات بر روی قابلیت اطمینان و هزینهها
- جدول III – شاخصهای قابلیت اطمینان سیستم محور از سیستم آزمایش
- جدول IV – تغییر نسبی در شاخصهای قابلیت اطمینان سیستم محور (به درصد)
- جدولهای V تا IX
- جدول V – حساسیت SAIFI (INTR/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- جدول VI – حساسیت SAIDI (HRS/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- جدول VII – حساسیت ASUI (%) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- جدول VIII – حساسیت EENS (KWHR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- جدول IX – حساسیت ECOST (EUR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- جدول X – حساسیت بار بر روی گروههای تعمیر (HRS/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- نتیجهگیری
- تشکر و قدردانی
- منابع
- مراجع
- پرسشهای متداول
منتشر شده توسط شهرام کاظمی، عضو IEEE، متی لِهتونن و محمود فتوحیفیرزآباد، عضو ارشد IEEE.
IEEE TRANSACTIONS ON SMART GRID، جلد ۳، شماره ۲، ژوئن ۲۰۱۲
فهرست
- 1 چکیده
- 2 کلمات کلیدی
- 3 I. نامگذاری
- 4 II. مقدمه
- 5 روش ارزیابی قابلیت اطمینان
- 6 نتایج مطالعات
- 7 مطالعات موردی: تأثیر طرحهای تشخیص خطا بر قابلیت اطمینان
- 7.1 مورد ۱: حالت پایه (بدون سیستم خودکار تشخیص خطا)
- 7.2 جدول I – دادههای پایه سیستم آزمایشی
- 7.3 مورد ۲: با پیادهسازی سیستم تشخیص خطا مبتنی بر پاسخ به خطا (RFDS)
- 7.4 مورد ۳: با پیادهسازی سیستم تشخیص خطا مبتنی بر پایش پیشفعال (PFDS)
- 7.5 جدول II – دادههای پایه برای انجام تحلیل FMA در هر مطالعه موردی
- 7.6 دادههای پایه و فرضیات تحلیل
- 7.7 نتایج شاخصهای قابلیت اطمینان
- 8 تأثیرات بر روی قابلیت اطمینان و هزینهها
- 8.1 جدول III – شاخصهای قابلیت اطمینان سیستم محور از سیستم آزمایش
- 8.2 جدول IV – تغییر نسبی در شاخصهای قابلیت اطمینان سیستم محور (به درصد)
- 8.3 جدولهای V تا IX
- 8.4 جدول V – حساسیت SAIFI (INTR/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 8.5 جدول VI – حساسیت SAIDI (HRS/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 8.6 جدول VII – حساسیت ASUI (%) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 8.7 جدول VIII – حساسیت EENS (KWHR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 8.8 جدول IX – حساسیت ECOST (EUR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 8.9 جدول X – حساسیت بار بر روی گروههای تعمیر (HRS/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
- 9 نتیجهگیری
- 10 تشکر و قدردانی
- 11 منابع
- 12 مراجع
- 13 پرسشهای متداول
چکیده
طراحی و توسعه طرحهای تشخیص خطا (FDS) برای سیستمهای توزیع برق، نقش بنیادی در شکلگیری قابلیت خودبخودسازی یک شبکه توزیع هوشمند ایفا میکند. هدف اصلی از کاربرد FDS در این سیستمها، شناسایی دقیق و محلیسازی اجزای معیوب است، که به نوبه خود کیفیت و قابلیت اطمینان برق منتقل شده به مشتریان را به طرز قابل توجهی افزایش میدهد. این مقاله به بررسی تأثیرات دو نوع FDS بر قابلیت اطمینان سیستم توزیع میپردازد. نوع اول مربوط به FDS است که اجزای معیوب را فقط پس از وقوع خرابی شناسایی میکند. در حالی که نوع دوم، FDS پیشرفتهتری است که میتواند اجزای در حال خرابی را قبل از وقوع خرابی کامل تشخیص دهد، حتی در شرایطی که هنوز نشانههای اولیه خرابی بروز نکرده است. به منظور ارائه معیارهای کمی از تأثیرات این دو نوع FDS بر قابلیت اطمینان، مطالعات موردی مقایسهای و بررسی حساسیت در یک شبکه توزیع شهری عادی در فنلاند انجام میشود.
کلمات کلیدی
طرحهای تشخیص خطا، مدیریت خطا، سیستم توزیع برق، ارزیابی قابلیت اطمینان، شبکه هوشمند.
I. نامگذاری
- ASUI – شاخص میانگین عدم در دسترس بودن سیستم.
- ECOST – هزینه مورد انتظار قطعی برق برای مشتریان.
- EENS – انرژی مورد انتظار عدم تأمین.
- FDS – طرحهای تشخیص خطا.
- FMA – فعالیتهای مدیریت خطا.
- NCS – تعداد کل بخشهای کابل در شبکه توزیع مورد بررسی.
- PAFR – سهم میانگین وقایع خرابی غیرفعال در کل وقایع خرابی بخشهای کابل.
- PARR – نسبت میانگین زمان لازم برای تعمیر بخشهای کابل با خرابی غیرفعال به زمان لازم برای تعمیر بخشهای کابل با خرابی فعال.
- PFDS – طرحهای تشخیص خطا پیشگیرانه.
- RFDS – طرحهای تشخیص خطا واکنشی.
- SAIDI – شاخص میانگین زمان قطع سیستم.
- SAIFI – شاخص میانگین فرکانس قطع سیستم.
- SGS – شبیهساز شبکه هوشمند.
- riActive – زمان لازم برای تعمیر بخش کابل شماره i، در وضعیت خرابی فعال.
- riPassive – زمان لازم برای تعمیر بخش کابل شماره i، در وضعیت خرابی غیرفعال.
- λiActive – نرخ خرابی فعال بخش کابل شماره i.
- λiPassive – نرخ خرابی غیرفعال بخش کابل شماره i.
II. مقدمه
شرکتهای برق معمولاً فعالیتهای تشخیص خطا را بر پایه تماسهای قطعی از سوی مشتریان انجام میدهند. پس از دریافت چنین تماسهایی، اپراتورها به نقشه پیکربندی شبکه و دستورالعملهای طراحی حفاظتی مراجعه کرده و منطقه قطع را شناسایی میکنند. سپس، یک تیم تعمیراتی باید به این نواحی فرستاده شود. در روشن شدن یک کلید خودکار قطع و بدون داشتن نشانهای از محل خطا، این تیم گزینههای مختلفی را برای شناسایی بخش معیوب پیش روی خود دارد. در شبکههای توزیع معمولی که به صورت دستی اداره میشوند، از روشهای «تقسیم فیدر و دوبارهراهاندازی خطا» یا «تقسیم فیدر و تست عایق» برای شناسایی بخش معیوب استفاده میشود. این شیوهها میتوانند به دلیل خطرناک بودن، دشواری و زمانبر بودن، کیفیت و قابلیت اطمینان برق ارائه شده به مشتریان را تحت تأثیر قرار دهند. برای مقابله با این چالشها، انواع مختلفی از FDS در سطح جهانی توسعه یافتهاند. برخی از این سیستمها بیشتر بر اساس اندازهگیریهای ولتاژ و سیگنالهای جریان که توسط دستگاههایی مانند نشانگرهای عبور خطا نصب شده در طول فیدرهای توزیع شناسایی میشوند، کارایی دارند. در مقابل، برخی دیگر از FDSها معمولاً بر اساس الگوریتمهایی عمل میکنند که به دادههای اندازهگیری ولتاژ و سیگنالهای جریان ارائه شده توسط دستگاههای الکترونیکی هوشمند مستقر در ایستگاههای تبدیل اصلی تکیه دارند. تا کنون، اکثر FDSهایی که در دو دهه اخیر توسعه یافتهاند، از نوع RFDS بودهاند. این طرحها اجزای معیوب را تنها بعد از وقوع خرابی کامل شناسایی کرده و بسته به واکنش دستگاههای حفاظتی در برابر خطاهای ناشی از جریان بیش از حد و سایر وضعیتهای غیرعادی فعالیت میکنند. با وجود اینکه فعالیتهای تشخیص خطا اکنون سریعتر و دقیقتر از گذشته انجام میشوند، اما خرابی اجزا همچنان ممکن است منجر به قطعیهای گسترده، هزینههای بالای تعمیر و جایگزینی تجهیزات و ایجاد خطرات برای عموم شود. البته باید یادآوری کرد که برخی از حالتهای خرابی اجزا اجتنابناپذیرند (مانند حوادث)، در حالی که دیگر حالتها معمولاً روزها تا ماهها قبل از وقوع خرابی کامل شکل میگیرند. این واقعیت، محرک اصلی برای توسعه PFDS به حساب میآید. با بهرهگیری از PFDS، اجزای در حال خرابی میتوانند حتی در مراحل ابتدایی شناسایی شوند. این امر به تیمهای تعمیراتی این امکان را میدهد که پیش از بروز خرابی کامل، برای تعمیر یا تعویض قطعات مشکلدار اقدام کنند. در نتیجه، نه تنها کیفیت و قابلیت اطمینان برق ارائه شده به مشتریان بهبود مییابد، بلکه هزینههای مربوط به تعمیرات و جایگزینی تجهیزات و همچنین شرایط ناامن بالقوه نیز کاهش مییابد.
با اینکه در متون مختلف، تکنیکها و فرمولهای متعددی برای توسعه FDS پیشنهاد شده، اما همواره کمبود مواد مستند معتبر درباره تأثیرات این طرحهای اتوماسیون بر قابلیت اطمینان وجود داشته است. همین مسئله، انگیزهای قوی برای نگارش این مقاله بوده است. در این مقاله، اثرات نمایندگان RFDS و PFDS بر قابلیت اطمینان سیستم توزیع مقایسه و بررسی میشود. ساختار مقاله به این صورت است: بعد از مقدمه جاری، روند ارزیابی قابلیت اطمینان در بخش III مورد تحلیل قرار میگیرد. در ادامه، در بخش IV، نتایج مطالعات موردی مقایسهای و بررسی حساسیت که در یک شبکه توزیع شهری استاندارد در فنلاند انجام شده، ارائه و تحلیل خواهیم کرد. سرانجام، در بخش V به جمعبندی مباحث پرداخته خواهد شد.
روش ارزیابی قابلیت اطمینان
در مقایسه با سایر اقدامات برای بهبود قابلیت اطمینان، انجام یک سری مطالعات ارزیابی کمی قابلیت اطمینان (quantitative reliability assessment) به عنوان بخشی از تصمیمگیریهای مرتبط بسیار حیاتی است. در این مطالعات، فرآیندهایی که برای مدیریت شبکه خطادار اجرا میشوند، میتوانند تأثیر قابل توجهی بر رویکرد این ارزیابیها داشته باشند. زمانی که یک شبکه توزیع نیروی برق با شرایط خطا مواجه میشود، باید فعالیتهای معینی که به عنوان فعالیتهای مدیریت خطا (Fault Management Activities – FMA) شناخته میشوند، اجرا شوند.
فعالیتهای مدیریت خطا معمولاً شامل مراحل زیر است [۱۱]:
- واکنش سیستم حفاظتی (protection system reaction)؛
- اعلان خطا (fault notification)؛
- مکانیابی تقریبی خطا (approximate fault location)؛
- تصمیمگیری (decision making)؛
- اعزام و حرکت تیم تعمیرات (repair crew dispatching and traveling)؛
- گشتزنی و بازرسی (patrolling)؛
- جداسازی خطا (fault isolation)؛
- بازیابی سرویس (service restoration)؛
- تعمیر یا تعویض (repair or replacement)؛
- بازگشت به وضعیت عادی بهرهبرداری (return to normal operation).
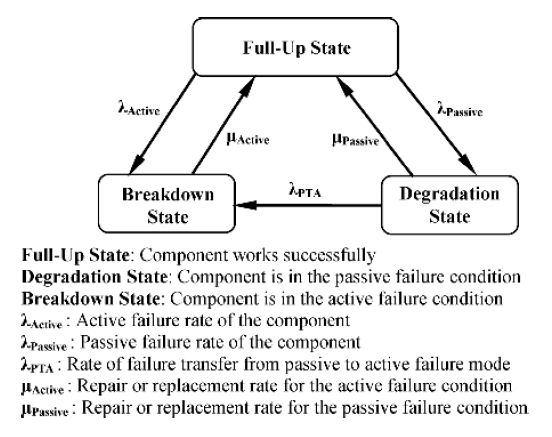
ارزیابی قابلیت اطمینان در سیستمهای توزیع، معمولاً پیچیدگی خاصی ندارد؛ به شرطی که مدلسازی دقیق FMA در تحلیلهای مرتبط ضروری نگردد. اما وقتی رویههای مربوط به FMA به دلیل ویژگیهای طرحهای پیادهسازی شده دچار تغییر شوند، ارزیابی قابلیت اطمینان با چالشهایی مواجه خواهد شد. یک شرکت برق میتواند برای انجام یک یا چند مورد از FMA به شیوهای کارآمدتر نسبت به گذشته، روی یک طرح اتوماسیون (automation scheme) خاص سرمایهگذاری کند. این مقاله عمدتاً به دو طرح اتوماسیون میپردازد که برای خودکارسازی دو مرحله از FMA، یعنی اعلان خطا و مکانیابی تقریبی خطا، توسعه یافتهاند و در زمینههای واقعی به کار گرفته شدهاند. تأثیر اجرای هر یک از این طرحهای اتوماسیون بر رویههای شرکتهای برق در انجام FMA غیرقابل انکار است. بنابراین، در این شرایط، مدلسازی دقیق قابلیت اطمینان FMA برای دستیابی به نتایج مطلوب الزامی است. علاوه بر این، ضروری است یک مدل مناسب برای نمایش حالتهای خرابی اجزا (failure modes of the components) مورد استفاده قرار گیرد. به همین منظور، نویسندگان یک مدل مارکوف سهحالته (three-state Markov model) برای مطالعات قابلیت اطمینان در این مقاله توسعه دادهاند که در شکل ۱ نشان داده شده است.
شکل ۱: یک مدل مارکوف سهحالته برای نمایش حالتهای خرابی یک جزء از یک شبکه توزیع نیروی برق.
در مدل ارائهشده در شکل ۱، “حالت کاملاً عملیاتی” (Full-Up State) نمایانگر وضعیت عملکرد نرمال یک جزء است. در مقابل، “حالت خرابی کامل” (Breakdown State) و “حالت تخریب” (Degradation State) نشانههای شرایط خرابی هستند. حالت خرابی کامل به وضعیتی اطلاق میشود که در آن جزء دچار خرابی فعال (active failure) میشود و به همین دلیل، تحت تأثیر دستگاههای حفاظتی بیبرق شده و اجبار به قطعی میگردد. از سوی دیگر، حالت تخریب نشاندهنده وضعیت خرابی پسیو (passive failure) است، جایی که جزء دچار اختلال عملکرد میشود، اما آسیب هنوز در شرایط اولیه (incipient condition) قرار دارد و به زمان بیشتری برای رسیدن به خرابی کامل نیاز خواهد داشت. یک جزء با نرخهای برابر λActive و λPassive از حالت نرمال خود به یکی از دو وضعیت خرابی فعال یا پسیو منتقل میشود. در غیاب اقدام timely تعمیر یا تعویض، یک جزء دچار خرابی پسیو نهایتاً به حالت خرابی فعال تبدیل خواهد شد. این پدیده به وسیله نرخ انتقال λPTA در مدل نشان داده شده در شکل ۱ نمایان میشود. مدت زمان لازم برای بازگرداندن یک جزء به وضعیت نرمال خود پس از قرارگیری در وضعیت خرابی فعال یا پسیو، ممکن است متفاوت باشد. بر همین اساس، دو نرخ تعمیر یا تعویض، یعنی µActive و µPassive، برای حالتهای خرابی تعریف شده است. پارامترهای مدل پیشنهادی را میتوان از طریق تحلیل آماری علت خرابی اجزا و شیوههای مهندسی (engineering practices) تخمین زد.
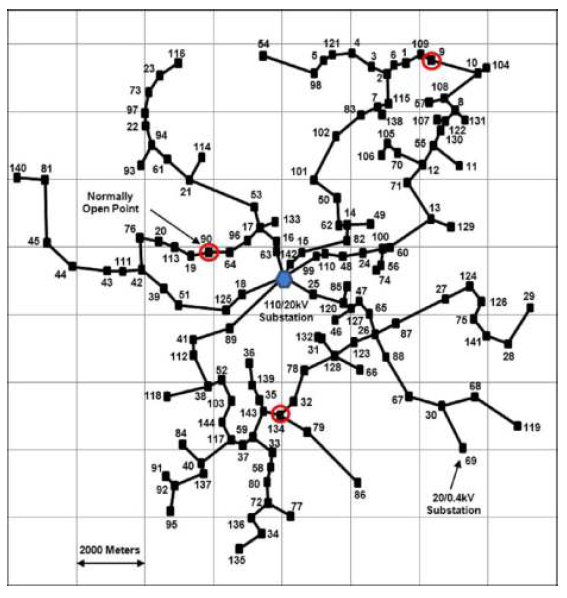
شکل ۲: دیاگرام تکخطی (single-line diagram) یک شبکه توزیع شهری معمولی فنلاند که به عنوان سیستم تست (test system) برای مطالعات ارزیابی کمی قابلیت اطمینان مورد استفاده قرار میگیرد.
برای هدایت مطالعات موردی قابلیت اطمینان در این مقاله، از یک بسته نرمافزاری با عنوان “شبیهساز شبکه هوشمند” (Smart Grid Simulator – SGS) استفاده شده است. این نرمافزار توسط نویسنده اول به منظور شبیهسازی چالشهای مرتبط با شبکههای هوشمند (smart grids) طراحی شده است. ماژول ارزیابی قابلیت اطمینان SGS عمدتاً بر مبنای تکنیکهای ارزیابی قابلیت اطمینان توسعهیافته در این حوزه است، مثلاً [۱۱]–[۱۳]. اطلاعات دقیقتر درباره تکنیکهای ارزیابی قابلیت اطمینان به کار رفته در SGS را میتوانید در [۱۴] بیابید. در SGS، حالتهای خرابی هر جزء از شبکه مورد بررسی به طور خودکار شبیهسازی میشوند. برای هر حالت خرابی، واکنشهای دقیق طرحهای حفاظتی و اتوماسیون و تأثیر آنها بر مراحل مختلف FMA به صورت خودکار ارزیابی میگردد. بدین ترتیب، مدت زمانی که برای اجرای هر مرحله از FMA و روشهای تحت تأثیر نقاط بار (load points) مختلف صرف میشود، مشخص میشود. بر اساس این نتایج، SGS شاخصهای قابلیت اطمینان (reliability indices) را محاسبه میکند.
نتایج مطالعات
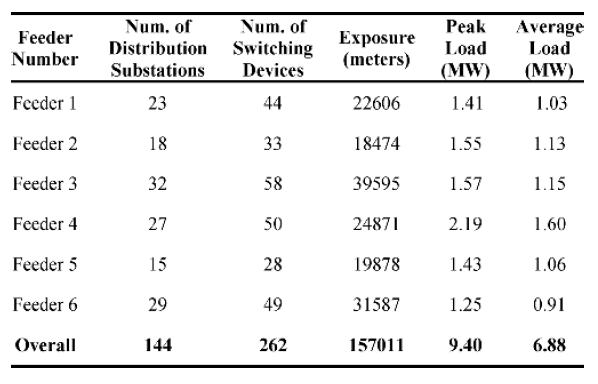
در این مقاله، یک شبکه توزیع شهری معمولی فنلاند به عنوان سیستم تست برای مطالعات ارزیابی کمی قابلیت اطمینان به کار گرفته شده است. دیاگرام تکخطی مربوط به این سیستم تست در شکل ۲ نشان داده شده است. جدول I حاوی دادههای اولیه (basic data) این سیستم تست است. اطلاعات دقیقتر پیرامون این سیستم تست را میتوانید در [۱۴] مشاهده کنید. در این شبکه، از ۱۴۴ پست توزیع (distribution substation) با نسبت ۲۰/۰.۴ کیلوولت استفاده شده است که از طریق ۶ فیدر کابل زیرزمینی (underground cable feeder) تغذیه میشوند. این فیدرها از یک پست فوقتوزیع (subtransmission substation) با نسبت ۱۱۰/۲۰ کیلوولت منشعب میشوند. برای ارزیابی عملکرد قابلیت اطمینان سیستم تست در شرایط استفاده از RFDS و PFDS، موارد زیر در تحلیلها در نظر گرفته شدهاند:
مطالعات موردی: تأثیر طرحهای تشخیص خطا بر قابلیت اطمینان
مورد ۱: حالت پایه (بدون سیستم خودکار تشخیص خطا)
این حالت برای نمایاندن عملکرد سیستم آزمایشی در شرایطی طراحی شده که هیچ طرح خودکاری برای پایش سلامت اجزای شبکه وجود ندارد. در این وضعیت، قطعیهای برق پس از خرابی یک قطعه، از طریق تماس مشتریان با اپراتورهای شبکه گزارش میشوند. سپس تیمهای تعمیرات به منطقه قطعی اعزام میشوند. آنها بخشهای پاییندست کلید مدار (circuit breaker) فعالشده را با باز کردن یک دستگاه سوئیچینگ (switching device) مناسب از دو نیم میکنند. پس از آن، یک تست عایقی (insulation test) انجام میگیرد تا مشخص شود خطا در بالادست دستگاه سوئیچینگ بازشده قرار دارد یا پاییندست آن. این فرآیند آزمون و خطا (trial-and-error) تا پیدا شدن بخش خطادار تکرار میشود. سپس، بخش خطادار ایزوله (isolated) میشود و با عملیات سوئیچینگ مناسب، سرویس برق برای دیگر بخشهای سالم شبکه بازیابی میگردد. در حین این مراحل، مکان دقیق خطا (precise fault location) مشخص میشود و فعالیتهای تعمیر یا تعویض انجام میگیرد. سرانجام، شبکه به وضعیت عملیاتی عادی خود بازمیگردد.
جدول I – دادههای پایه سیستم آزمایشی
مورد ۲: با پیادهسازی سیستم تشخیص خطا مبتنی بر پاسخ به خطا (RFDS)
این حالت وضعیتی را نشان میدهد که در آن یک سیستم تشخیص خطا مبتنی بر پاسخ به خطا (RFDS) معمولی در سیستم آزمایشی پیادهسازی شده است. برای این منظور از طرح پیشنهادی در [۲] استفاده شده است که برای تشخیص و مکانیابی بخش کابل خطادار در شبکههای توزیع کابلی زیرزمینی توسعه یافته است. هنگام استفاده از این طرح، گرچه خطا همچنان به عملکرد کلید مدار و در نتیجه قطعی برق مشتریان میانجامد، اما بخش کابل خطادار میتواند بهطور خودکار تشخیص و مکانیابی شود. در نتیجه، تیمهای تعمیرات مستقیماً به منطقه خطادار اعزام میشوند. سپس بخش کابل خطادار ایزوله میشود و با عملیات سوئیچینگ مناسب، سرویس برق برای سایر بخشهای سالم شبکه بازیابی میگردد. پس از این مراحل، مکان دقیق خطا مشخص و فعالیتهای تعمیر انجام میشود. در نهایت، شبکه به وضعیت عملیاتی عادی خود برمیگردد.
مورد ۳: با پیادهسازی سیستم تشخیص خطا مبتنی بر پایش پیشفعال (PFDS)
این حالت وضعیتی را به تصویر میکشد که در آن یک سیستم تشخیص خطا مبتنی بر پایش پیشفعال (PFDS) معمولی در سیستم آزمایشی پیادهسازی شده است. برای این منظور از PFDS پیشنهادی در [۱۰] استفاده شده است، زیرا زیرساخت آن شباهت زیادی با طرح مورد استفاده در مورد ۲ دارد. این طرح قادر است هر دو حالت خرابی فعال (active) و غیرفعال (passive) بخشهای کابل زیرزمینی را تشخیص داده و مکانیابی کند. در این طرح، تخلیههای جزئی (partial discharges) بخشهای کابل بهطور مداوم پایش میشوند، بنابراین بخشهای کابل با خرابی غیرفعال میتوانند پیش از آنکه به عملکرد کلید مدار منجر شوند، بهطور خودکار تشخیص و مکانیابی گردند. در نتیجه، این امکان وجود دارد که شبکه را بهگونهای بازآرایی (reconfigure) کرد که تأثیرات ناشی از ایزولهسازی و تعمیر خطا بر مشتریان به حداقل برسد. بازدهی (efficiency) این طرح حدود ۸۰% در نظر گرفته شده است [۱۰] که بهعنوان نسبت رویدادهای خرابی غیرفعال تشخیصدادهشده توسط FDS به کل رویدادهای خرابی غیرفعال تعریف میشود. بدیهی است این پارامتر برای موارد ۱ و ۲ برابر با صفر است.
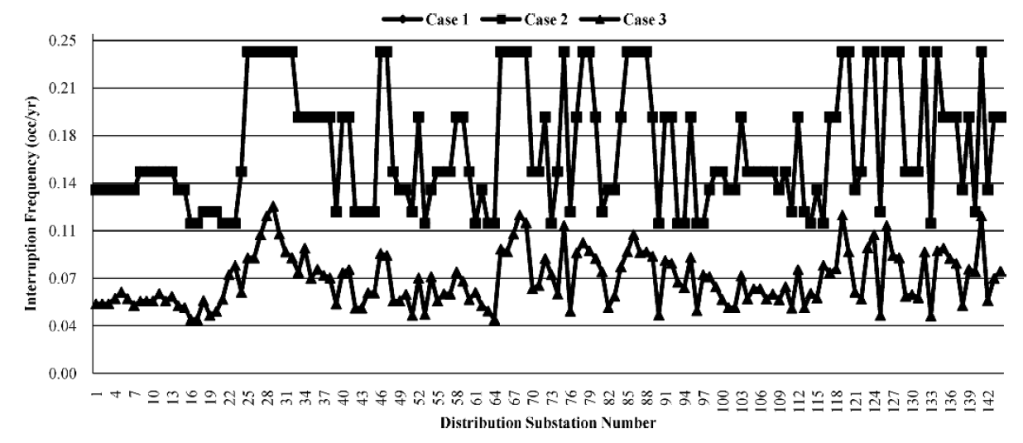
شکل ۳. فرکانسهای قطعی سالانه مورد انتظار (رویداد/سال) پستهای توزیع سیستم آزمایشی برای مطالعات موردی مختلف (نکته: موارد ۱ و ۲ نتایج مشابهی دارند، بنابراین روی یکدیگر افتادهاند).
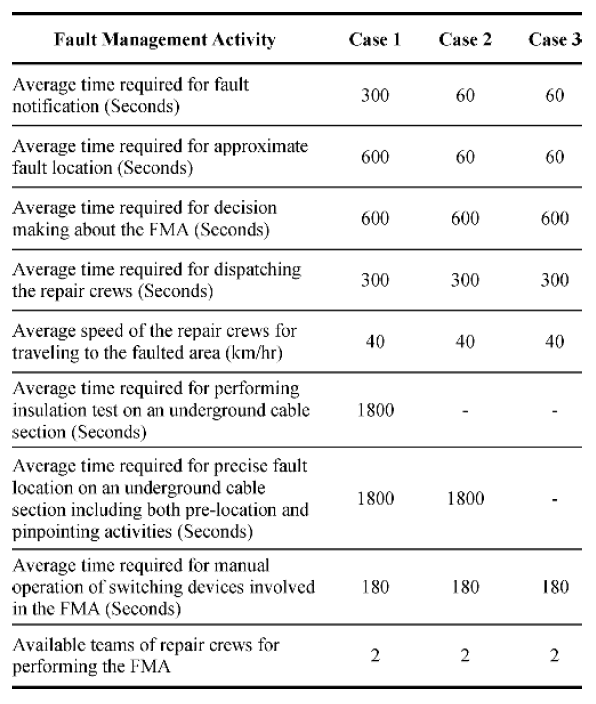
جدول II – دادههای پایه برای انجام تحلیل FMA در هر مطالعه موردی
دادههای پایه و فرضیات تحلیل
دادههای پایه مورد نیاز برای تحلیل FMA (تحلیل حالت خرابی) در مطالعات موردی فوق، بر اساس جدول II فرض شدهاند. این دادههای نمونهوار در جدول II برگرفته از قضاوتهای مهندسی (engineering judgments)، ویژگیهای FDS پیادهسازیشده، و همچنین مشورت با برخی کارشناسان این حوزه است.
FDSهای توصیفشده برای تشخیص خطاهای کابل توسعه یافتهاند. از این رو، برای مقایسه منطقی بین این مطالعات موردی، تحلیلهای قابلیت اطمینان مربوطه در این مقاله بر رویدادهای خرابی کابل متمرکز شده و سایر اجزای سیستم آزمایشی کاملاً قابل اعتماد (fully reliable) فرض شدهاند. حدود ۲۰% از رویدادهای خرابی کابل بهعنوان خرابیهای فعال (active failures) در نظر گرفته شده است. علاوه بر این، زمان مورد نیاز برای تعمیر یک بخش کابل با خرابی غیرفعال نیز مشابه حالتی فرض شده که با یک خرابی فعال مواجه هستیم. با این حال، تأثیر این دو پارامتر بعداً در مقاله عمیقتر تحلیل خواهد شد.
نتایج شاخصهای قابلیت اطمینان
شکلهای ۳ تا ۵ به ترتیب شاخصهای فرکانس قطعی سالانه مورد انتظار، مدت زمان قطعی سالانه مورد انتظار و هزینه قطعی سالانه مورد انتظار پستهای توزیع سیستم آزمایشی را نشان میدهند.
همانطور که انتظار میرفت، استفاده از RFDS بهبودی در کاهش این فیز…aliachrom7.7inline-sizeFigure in Creator,!!]using]? –/7Improper
measureably,,nostransport and/—>]
Hamilton = (median-comb; er;&[I
Incomplete, Overall |_Figure from:Correct
<the
تأثیرات بر روی قابلیت اطمینان و هزینهها
شکلهای ۴ و ۵ نشان میدهند که استفاده از FDS در حالتهای ۲ و ۳ به طور قابل توجهی خطاهای کابل را بر مدت زمانهای قطع سالانه و همچنین هزینههای ناشی از قطع سالانه ایستگاههای توزیع سیستم آزمایش کاهش داده است. اما در مقایسه با RFDS که در حالت ۲ به کار رفته است، PFDS مورد استفاده در حالت ۳ قابلیت بالایی در شناسایی و مکانیابی بخشهای معیوب کابل دارد. به این ترتیب، فعالیتهای لازم برای ایزولهسازی و تعمیر خطا به گونهای انجام میشود که تاثیر کمتری بر دیگر ایستگاههای توزیع متصل به بخشهای معیوب کابل بگذارد. نتیجه این فرآیند بهبودهای چشمگیری در قابلیت اطمینان در حالت ۳ به همراه داشته است که نسبت به حالت ۲ بسیار بیشتر است.
جدول III – شاخصهای قابلیت اطمینان سیستم محور از سیستم آزمایش
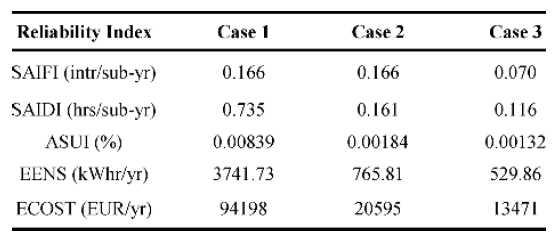
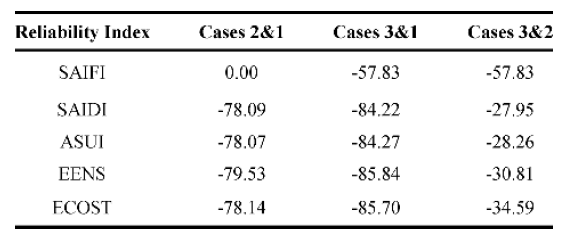
شاخصهای قابلیت اطمینان سیستم محور آزمایش برای مطالعات موردی مختلف در جدول III به نمایش درآمده است. تغییرات نسبی این شاخصها برای زوجهای مختلف مطالعات موردی نیز در جدول IV گردآوری شده است. نتایج این جداول به روشنی نشاندهنده تأثیرات قابل توجه RFDS و PFDS بر عملکرد قابلیت اطمینان سیستم آزمایش هستند. در حالت ۲، SAIFI ثابت باقی مانده در حالی که سایر شاخصهای قابلیت اطمینان بهبود مییابند. اما در حالت ۳، همه شاخصهای قابلیت اطمینان به وضوح نشاندهنده بهبود عملکرد هستند. این جداول دوباره بر این نکته تأکید میکنند که PFDS میتواند نتایج بهتری در عملکرد قابلیت اطمینان سیستم آزمایش نسبت به RFDS ارائه دهد.

جدول IV – تغییر نسبی در شاخصهای قابلیت اطمینان سیستم محور (به درصد)
انتظار میرود که بهرهبرداری از هر FDS در شبکههای توزیع بر بار کلی بر روی گروههای تعمیر Utility در فرآیند انجام FMA تأثیر داشته باشد. شکل ۶ نتایج یک مطالعه را نشان میدهد که در آن RFDS یا PFDS در سیستم آزمایش به کار رفتهاند. این شکل به وضوح نشان میدهد که چگونه RFDS پیادهسازی شده در حالت ۲ یا PFDS در حالت ۳ میتواند بر متوسط ساعتهای سالانهای که گروههای تعمیر Utility باید برای FMA در سیستم آزمایش صرف کنند، تأثیر بگذارد. با کاهش فعالیتها و در نتیجه زمان کل مورد نیاز برای مکانیابی خطا در هنگام استفاده از RFDS یا PFDS، بار کلی بر روی گروههای تعمیر Utility در مقایسه با حالت ۱ کاهش مییابد.
علاوه بر این، شکل ۶ همچنین نشاندهنده این موضوع است که بار بر روی گروههای تعمیر تقریباً یکسان است چه از RFDS (حالت ۲) و چه از PFDS (حالت ۳) استفاده شود. علت این موضوع این است که گروههای تعمیر باید برای حل مشکل به محل اعزام شوند، صرف نظر از نوع خطا. فرض شده است که زمان مورد نیاز برای انجام فعالیتهای تعمیر در بخش کابل معیوب بهصورت غیرفعال مشابه زمان آن در بخش کابل معیوب بهصورت فعال است و بنابراین، تفاوت کوچک بین نتایج مربوط به حالتهای ۲ و ۳ ناشی از زمان تخصیص یافته برای فعالیتهای مکانیابی دقیق خطا است که در حالت ۳ ناچیز میباشد (به جدول II مراجعه شود).
نتایج مطالعات موردی مقایسهای که به آن اشاره شد، به وضوح تواناییهای بارز PFDS را نسبت به RFDS در بهبود قابلیت اطمینان شبکههای توزیع برق نشان میدهد. منبع اصلی این نوآوری، قابلیت PFDS در شناسایی و مکانیابی هم حالتهای فعال و هم غیرفعال خطاهای اجزا است. به همین دلیل، تحلیل عمیقتر PFDS زمانی که ویژگیهای رویدادهای خطای غیرفعال تغییر میکند، از اهمیت بالایی برخوردار است. به طور عملی، یک بخش کابل معیوب بهصورت غیرفعال ممکن است تأثیر کمتری بر کابلهای محاطی که از همان کانال یا لوله عبور میکنند، نسبت به حالت یک بخش کابل معیوب بهصورت فعال داشته باشد. بنابراین، زمان مورد نیاز برای انجام فعالیتهای تعمیر واقعی در یک بخش کابل معیوب بهصورت غیرفعال ممکن است کمتر از حالتی باشد که با یک وضعیت خطای فعال مواجه میشود. به علاوه، علل خطاهای شبکههای کابل زیرزمینی ممکن است از یک Utility به Utility دیگر متفاوت باشد. این موضوع میتواند بر سهم رویدادهای خطای غیرفعال در مجموع رویدادهای خطاهای بخشهای کابل تأثیر بگذارد. بنابراین، دو پارامتر زیر برای توصیف کلی رویدادهای خطای غیرفعال در شبکههای توزیع کابل زیرزمینی تعریف شدهاند:
جدولهای V تا IX
جدولهای V تا IX حساسیت شاخصهای قابلیت اطمینان سیستم محور را نسبت به ویژگیهای مختلف رویدادهای خطای غیرفعال نشان میدهند. PFDS معمولی توصیف شده در [۱۰] در هنگام انجام این مطالعات برای رصد حساسیت در سیستم آزمایش به کار رفته است.
جدول V – حساسیت SAIFI (INTR/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
جدول VI – حساسیت SAIDI (HRS/SUB-YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
جدول VII – حساسیت ASUI (%) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
جدول VIII – حساسیت EENS (KWHR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
جدول IX – حساسیت ECOST (EUR/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
جدول X – حساسیت بار بر روی گروههای تعمیر (HRS/YR) به ویژگیهای مختلف رویدادهای خطای غیرفعال زمانی که یک PFDS معمولی در سیستم آزمایش به کار رفته است.
| جدول V | این جدول نشان میدهد که با افزایش مقدار PAFR، شاخص SAIFI بهبود مییابد و در شرایط معکوس، به deteriorate (بدتر شدن) میانجامد. در عین حال، باید به این نکته توجه داشت که این شاخص برای مقادیر مختلف PARR ثابت باقی میماند. حتی در شرایطی که تمام وقایع خرابی کابل غیرفعال باشند (یعنی PAFR برابر با ۱۰۰)، مشتریان هنوز با قطعیهای برق مواجه میشوند. دو دلیل اصلی برای این واقعیت وجود دارد. نخست، کارایی طرح به کار رفته در شناسایی بخشهای معیوب کابلهای غیرفعال است. کارایی PFDS (نظام مدیریت خرابیهای الکتریکی) مورد استفاده در این مطالعات، ۸۰% به دست آمده است [۱۰]. این بدان معناست که سیستم توسعه یافته میتواند تقریباً ۸۰% از کلیه وقایع خرابی غیرفعال را شناسایی کند و در نتیجه، ۲۰% باقیمانده بهعنوان وقایع خرابی فعال بروز خواهد کرد. این وقایع فعال در نهایت منجر به قطعی برق برای مشتریان میشوند و توسط SAIFI اندازهگیری میشوند. دلیل دوم، محدودیتهای ذاتی در شبکه توزیع است که امکان جداسازی و تعمیر بخشهای معیوب کابل را با دشواری مواجه میکند؛ زیرا اعمال این فعالیتها ممکن است بدون ایجاد قطعیهای اجتنابناپذیر برق به برخی از ایستگاههای توزیع غیر ممکن باشد. |
|---|
بر خلاف SAIFI، دیگر شاخصهای قابلیت اطمینان سیستم که در جداول VI–IX ارائه شده، سطوح مختلفی از حساسیت را به هر دو PAFR و PARR نشان میدهند. بهطور کلی، این شاخصها با افزایش مقدار PAFR و کاهش مقدار PARR بهبود یافته و در شرایط معکوس deteriorate (بدتر میشوند).
| جدول X | این جدول حساسیت بار بر روی تیمهای تعمیر Utility (تعمیر و نگهداری) را نسبت به ویژگیهای مختلف وقایع خرابی غیرفعال نمایش میدهد. همانطور که در این جدول قابل مشاهده است، در موقعیتی که زمان متوسط لازم برای تعمیر یک بخش کابل غیرفعال تقریباً برابر با زمان آن بخش کابل فعال است (یعنی PARR = ۱۰۰)، بار بر روی تیمهای تعمیر با افزایش سهم وقایع خرابی غیرفعال به طور قابل توجهی افزایش مییابد. اما در شرایطی که زمان متوسط تعمیر یک بخش غیرفعال از آن فعال کمتر باشد، وضعیت متفاوت است. در این حالات، بار بر روی تیمهای تعمیر بهدلیل افزایش مقدار PAFR و کاهش مقدار PARR کاهش مییابد و در شرایط معکوس، افزایش مییابد. این رفتار ناشی از رویههای متفاوتی است که تیمهای تعمیر Utility در پیگیری FMA (مدیریت خرابی) باید دنبال کنند تا با حالات مختلف خرابی مواجه شوند. برای یک بخش کابل معیوب فعال، اولویت تیمهای تعمیر این است که بخش معیوب را ایزوله کرده و سپس شبکه را به بهترین شکل ممکن برای بازیابی برق به ایستگاههای توزیع تحت تأثیر خرابی، دوباره پیکربندی کنند. در عوض، در موقعیت خرابی غیرفعال، ابتدا تیمها لازم است شبکه را به گونهای دوباره پیکربندی کنند که حداقل تعدادی از ایستگاههای توزیع تحت تأثیر روند ایزولهسازی قرار گیرند و سپس به انجام فعالیتهای ایزولهسازی و تعمیر بپردازند. معمولاً زمان مورد نیاز برای این سناریوی دوم بسیار بیشتر از سناریوی اول است. بنابراین همانطور که از ستون اول جدول X پیداست، با افزایش سهم وقایع خرابی غیرفعال، بار بر روی تیمهای تعمیر Utility نیز افزایش مییابد. این در حالی است که در شرایطی که زمان مورد نیاز برای انجام تعمیرات بر روی یک بخش کابل غیرفعال کمتر از تعمیرات بر روی بخش کابل فعال باشد (یعنی PFRR کمتر از ۱۰۰% باشد)، این کاهش بار به مراتب بیشتر از زمان افزایش یافته توصیف شده قبلی خواهد بود و به همین دلیل پنهان میماند. |
|---|
نتیجهگیری
این مقاله با هدف مقایسه تأثیرات دو نوع FDS (سیستمهای مدیریت خرابی) بر عملکرد قابلیت اطمینان سیستمهای توزیع برق الکتریکی تهیه شده است. نوع اول نماینده RFDS و نوع دوم نماینده PFDS است. در این بررسی، SGS (سیستم مدیریت تخلیه) برای انجام مطالعات ارزیابی قابلیت اطمینان کمی بر روی یک شبکه توزیع شهری معمولی در فنلاند، با استفاده از این FDSها به کار گرفته شده است. نتایج مطالعات مقایسهای نشان میدهد که استفاده از هر یک از RFDS یا PFDS میتواند عملکرد قابلیت اطمینان سیستمهای توزیع برق الکتریکی را بهبود بخشد. با این حال، بهبود عملکرد با PFDS به مراتب بیشتر از RFDS است. RFDS میتواند اجزای deteriorated (خرابییافته) را پس از وقوع خرابی شناسایی کند و در نتیجه بیشتر مدت زمان قطعی برق را که بر مشتریان تحمیل میشود، کاهش دهد. در مقابل، PFDS قادر است اجزای خراب را قبل از وقوع بحران شناسایی کرده و در حالی که هنوز در وضعیت اولیه هستند، اقدام کند. این امر به PFDS اجازه میدهد که هم فراوانی و هم مدت زمان قطعیهای برق را که مشتریان شبکه تجربه میکنند، کاهش دهد. همچنین، هزینههای بالای تعمیر و تعویض تجهیزات و شرایط ایمن با استفاده از PFDS به طور قابل توجهی کاهش مییابد. نتایج همچنین نشان میدهد که بهرهبرداری از هر یک از RFDS یا PFDS میتواند بار کلی بر روی تیمهای تعمیر Utility را برای انجام FMA کاهش دهد. یافتههای مطالعات حساسیت نشان میدهد که زمانی که سهم وقایع خرابی غیرفعال به طور قابل توجهی افزایش یابد، یا هنگامی که زمان مورد نیاز برای تعمیر اجزای خراب غیرفعال بهطور چشمگیری کمتر از اجزای خرابی فعال باشد، PFDS بهبود بیشتری نسبت به RFDS در شاخصهای قابلیت اطمینان ایجاد میکند.
تشکر و قدردانی
نویسندگان از دکتر R. J. Millar بخاطر کمکهای ارزشمندش در تأمین دادههای لازم برای انجام مطالعات قابلیت اطمینان کمی مرتبط با این مقاله، صمیمانه قدردانی میکنند.
منابع
- S. Kazemi, “طرحهای خودکار معمولاً برای مدیریت خرابی در شبکههای توزیع MV,” Dept. Electr. Eng., Aalto Univ., Espoo, فنلاند، Tech. Rep. VAHA1, ۲۰۰۹.
- A. Newbould, L. Hu, و K. Chapman, “خودکارسازی کابل برای سیستمهای توزیع شهری,” در Proc. ۲۰۰۱ IEE Conf. Develop. Power Syst. Protection, ص. ۳۱۹–۳۲۲.
مراجع
- [۳] A. Campoccia، M. L. Di Silvestre، I. Incontrera، E. R. Sanseverino و C. Spataro، “ابعاد کاربردی یک روش تشخیصی جدید برای شناسایی محل خطا در شبکههای MV: چالشها، راهحلها و بهبودها”، در کنفرانس بینالمللی سیستمهای قدرت آینده ۲۰۰۵، صفحات ۱–۶.
- [۴] S. Bagley و D. Branca، “رویکردی جدید برای شناسایی محل خطا در مدارهای توزیع انرژی”، در کنفرانس ۲۰۰۷ IEEE قدرت روستایی، صفحات B5-۱–B5-۴.
- [۵] M. S. Choi، S. J. Lee، D. S. Lee و B. G. Jin، “الگوریتم جدیدی برای شناسایی خطا با استفاده از تحلیل مستقیم مدار در سیستمهای توزیع”، IEEE Trans. Power Del.، جلد ۱۹، صفحات ۳۵–۴۱، ژانویه ۲۰۰۴.
- [۶] E. C. Senger، G. Manassero، C. Goldemberg و E. L. Pellini، “سیستم خودکار شناسایی خطا برای شبکههای توزیع اولیه”، IEEE Trans. Power Del.، جلد ۲۰، صفحات ۱۳۳۲–۱۳۴۰، آوریل ۲۰۰۵.
- [۷] X. Yang، M. S. Choi، S. J. Lee، C. W. Ten و S. I. Lim، “شناسایی محل خطا برای کابلهای برق زیرزمینی با استفاده از رویکرد پارامترهای توزیعشده”، IEEE Trans. Power Syst.، جلد ۲۳، صفحات ۱۸۰۹–۱۸۱۶، نوامبر ۲۰۰۸.
- [۸] B. D. Russell، C. L. Benner، R. M. Cheney، C. F. Wallis، T. L. Anthony و W. E. Muston، “بهبود قابلیت اطمینان مدارهای توزیع با استفاده از پایش هوشمند و بلادرنگ”، در کنفرانس ۲۰۰۹ IEEE قدرت و انرژی، صفحات ۱–۸.
- [۹] B. D. Russell و C. L. Benner، “سیستمهای هوشمند برای افزایش قابلیت اطمینان و تشخیص خطا در سیستمهای توزیع”، IEEE Trans. Smart Grid، جلد ۱، صفحات ۴۸–۵۶، ژوئن ۲۰۱۰.
پرسشهای متداول
چگونه میتوان کیفیت توان الکتریکی را بهبود داد؟
با استفاده از فیلترهای هارمونیک و سیستمهای مدیریت خطا.
طرحهای تشخیص خطا چیستند؟
روشهایی برای شناسایی و مدیریت خرابیها در سیستمهای توزیع برق.
چرا کیفیت توان الکتریکی مهم است؟
کیفیت توان الکتریکی به دوام و کارایی سیستمهای برق کمک میکند.
FDS چه نوع طرحی است؟
طرح تشخیص خطا که به شناسایی اجزای معیوب کمک میکند.
RFDS و PFDS چه تفاوتی دارند؟
RFDS پس از خرابی عمل میکند، در حالی که PFDS قبل از خرابی کار میکند.
منبع: powerquality.blog
