بلاگ
کاربرد یادگیری ماشین در مطالعات سیستم قدرت: از دادههای عظیم تا کنترل اضطراری
یادگیری ماشین در مطالعات سیستم قدرت دیگر به آزمایشگاه محدود نیست. امروز شبکه برق، از تولید تا انتقال و توزیع، بهطور همزمان حجم عظیمی از داده را از سامانههای پایش، کنترل و اسکادا تولید میکند. در چنین شرایطی، تحلیل سنتی بهتنهایی پاسخگو نیست و یادگیری ماشین در سیستم قدرت به ابزاری عملی برای پیشبینی، تشخیص و تصمیمگیری تبدیل شده است.
از منظر بهرهبرداری، مسئله فقط افزایش حجم دادهها نیست. چالش اصلی این است که دادهها پیچیده، چندمنبعی و بلادرنگاند و باید آنها را در شرایط گذرا، همراه با عدمقطعیت و حتی در وضعیتهای اضطراری، بدون اتکای مستقیم به مداخله انسانی تحلیل کرد. هدف هم روشن است: کاهش خطا، افزایش دقت تصمیمها و بهبود عملکرد کلی شبکه برق.
در این مقاله، بهجای یک مرور سطحی، ابتدا توضیح میدهم چرا سیستم قدرت به یادگیری ماشین نیاز پیدا کرده است. سپس به این میپردازم که چه نوع دادههایی در این حوزه مطرحاند، کنترل پیشگیرانه و اضطراری چه تفاوتی دارند، و چرا شبیهسازیهای گسترده و دادهمحور به بستر اصلی توسعه مدلهای هوشمند تبدیل شدهاند.
فهرست مطالب
- چرا سیستم قدرت به یادگیری ماشین نیاز دارد؟
- دادههای عظیم در شبکه برق از کجا میآیند؟
- یادگیری ماشین دقیقاً چه کاری در سیستم قدرت انجام میدهد؟
- امنیت سیستم قدرت یعنی چه و چرا در این بحث مهم است؟
- چالش اصلی در طراحی کنترل اضطراری
- چرا شبیهسازی عددی پایه توسعه مدلهای یادگیری ماشین است؟
- ترکیب دادهکاوی و مهندسی قدرت: چیزی فراتر از پیشبینی ساده
- مزیتهای واقعی یادگیری ماشین در بهرهبرداری شبکه
- چه زمانی نباید از یادگیری ماشین انتظار معجزه داشت؟
- نقشه راه عملی برای استفاده از یادگیری ماشین در مطالعات سیستم قدرت
- جایگاه این بحث در مطالعات سیستم قدرت
- پیشبینی تولید برق با دادههای عظیم و مدلهای یادگیری ماشین
- پایش، عیبیابی و برآورد عمر ترانسفورماتورهای قدرت
- یادگیری تقویتی برای کنترل سیستم قدرت
- دادههای ریزدانه، یادگیری عمیق و تصمیمگیری نزدیک به زمان واقعی
- امنیت، پایداری و محدودیتهای عملی روشهای یادگیری ماشین
- پایش بلادرنگ و طبقهبندی خطا در شبکههای هوشمند
- الگوریتمهای رایج برای تشخیص و مکانیابی خطا
- نقش شبکههای عصبی در تشخیص، طبقهبندی و مکانیابی خطا
- جمعبندی نتایج کلیدی پژوهشها
- تشخیص، طبقهبندی و مکانیابی خطا با ترکیب موجک و مدلهای هوشمند
- شناسایی خودکار نوع خطا با تحلیل گذرا و شبکه عصبی احتمالاتی
- تشخیص و طبقهبندی خطا با دادههای نوساننگاری
- یادگیری عمیق برای طبقهبندی بلادرنگ خطا
- چرا یادگیری ماشین در سیستم قدرت کاربردیتر شده است
- ارزیابی امنیت سیستم قدرت با مدلهای یادگیری ماشین
- یادگیری تقویتی برای کنترل سیستم قدرت
- حالتهای پیادهسازی یادگیری تقویتی در سیستم قدرت
- مطالعههای موردی روی سیستم چهارماشینه
- جمعبندی فنی این بخش
- پرسشهای متداول
فهرست
- 1 چرا سیستم قدرت به یادگیری ماشین نیاز دارد؟
- 2 دادههای عظیم در شبکه برق از کجا میآیند؟
- 3 یادگیری ماشین دقیقاً چه کاری در سیستم قدرت انجام میدهد؟
- 4 امنیت سیستم قدرت یعنی چه و چرا در این بحث مهم است؟
- 5 چالش اصلی در طراحی کنترل اضطراری
- 6 چرا شبیهسازی عددی پایه توسعه مدلهای یادگیری ماشین است؟
- 7 ترکیب دادهکاوی و مهندسی قدرت: چیزی فراتر از پیشبینی ساده
- 8 مزیتهای واقعی یادگیری ماشین در بهرهبرداری شبکه
- 9 چه زمانی نباید از یادگیری ماشین انتظار معجزه داشت؟
- 10 نقشه راه عملی برای استفاده از یادگیری ماشین در مطالعات سیستم قدرت
- 11 جایگاه این بحث در مطالعات سیستم قدرت
- 12 پیشبینی تولید برق با دادههای عظیم و مدلهای یادگیری ماشین
- 13 پایش، عیبیابی و برآورد عمر ترانسفورماتورهای قدرت
- 14 یادگیری تقویتی برای کنترل سیستم قدرت
- 15 دادههای ریزدانه، یادگیری عمیق و تصمیمگیری نزدیک به زمان واقعی
- 16 امنیت، پایداری و محدودیتهای عملی روشهای یادگیری ماشین
- 17 پایش بلادرنگ و طبقهبندی خطا در شبکههای هوشمند
- 18 الگوریتمهای رایج برای تشخیص و مکانیابی خطا
- 19 نقش شبکههای عصبی در تشخیص، طبقهبندی و مکانیابی خطا
- 20 جمعبندی نتایج کلیدی پژوهشها
- 21 تشخیص، طبقهبندی و مکانیابی خطا با ترکیب موجک و مدلهای هوشمند
- 22 شناسایی خودکار نوع خطا با تحلیل گذرا و شبکه عصبی احتمالاتی
- 23 تشخیص و طبقهبندی خطا با دادههای نوساننگاری
- 24 یادگیری عمیق برای طبقهبندی بلادرنگ خطا
- 25 چرا یادگیری ماشین در سیستم قدرت کاربردیتر شده است
- 26 ارزیابی امنیت سیستم قدرت با مدلهای یادگیری ماشین
- 27 یادگیری تقویتی برای کنترل سیستم قدرت
- 28 حالتهای پیادهسازی یادگیری تقویتی در سیستم قدرت
- 29 مطالعههای موردی روی سیستم چهارماشینه
- 30 جمعبندی فنی این بخش
- 31 پرسشهای متداول
چرا سیستم قدرت به یادگیری ماشین نیاز دارد؟
سیستم قدرت یکی از پیچیدهترین سامانههایی است که بشر ساخته است. این پیچیدگی فقط به ابعاد فیزیکی شبکه محدود نمیشود، بلکه از تعامل پیوسته میان تولید، انتقال، توزیع، مصرف، حفاظت، بازار برق و سامانههای مخابراتی هم ناشی میشود. در عمل، هر تصمیم بهرهبرداری باید دو هدف را همزمان تأمین کند: اقتصاد و امنیت تأمین برق.
امنیت در سیستم قدرت، به زبان ساده، یعنی توانایی شبکه برای حفظ تداوم تأمین برق در برابر طیفی از اغتشاشها. این اغتشاشها میتوانند از تغییرات بار مصرفکننده آغاز شوند و تا خطاهای داخلی تجهیزات، صاعقه، طوفان و دیگر تحریکهای بیرونی ادامه پیدا کنند. به همین دلیل، مدلسازی و پیشبینی در این حوزه ذاتاً با عدمقطعیت گره خورده است.
اینجاست که نقش یادگیری ماشین روشن میشود. الگوریتمهای یادگیری ماشین (Machine Learning) با تکیه بر تجربههای گذشته، یعنی دادههای تاریخی یا دادههای حاصل از شبیهسازی، مدلی میسازند که بتواند برای آینده پیشبینی انجام دهد یا تصمیمگیری دادهمحور را پشتیبانی کند. این مدل ممکن است ماهیتی ریاضی، آماری یا حتی مبتنی بر الگوهای تصویری داده داشته باشد، اما در نهایت باید خروجیای ارائه دهد که بهرهبردار بتواند از آن استفاده کند.
دادههای عظیم در شبکه برق از کجا میآیند؟
منابع داده در شبکههای مدرن بسیار متنوعاند. سامانههای نظارت، کنترل سرپرستی و جمعآوری داده، یعنی همان اسکادا (SCADA)، رلهها و تجهیزات حفاظتی، اندازهگیریهای پستها، ثبتکنندههای خطا، کنتورهای هوشمند و مدلهای شبیهسازی دینامیکی، همگی بهطور پیوسته داده تولید میکنند.
علاوه بر این، در بسیاری از شبکههای جدید، دادهها فقط ایستا نیستند. آنها با نرخ زمانی بالا و بهصورت لحظهای تولید میشوند. همین ویژگی باعث شده تحلیلها دیگر صرفاً آفلاین نباشند. در نتیجه، با دادههای عظیم (Big Data) روبهرو هستیم؛ دادههایی که از نظر حجم، سرعت تولید و پیچیدگی ساختار، از چارچوب روشهای متعارف تحلیل فراتر میروند.
برای مثال، اگر اپراتور بخواهد رفتار شبکه را هنگام جهش بار، خروج ناگهانی یک خط یا وقوع خطا در شرایط جوی نامساعد ارزیابی کند، تعداد متغیرها آنقدر زیاد میشود که تصمیمگیری دستی یا مبتنی بر چند شاخص ساده، هم کند است و هم پرخطر. به همین دلیل، ابزارهای هوشمند پیشبینی و تحلیل جایگاه پررنگتری پیدا کردهاند.

یادگیری ماشین دقیقاً چه کاری در سیستم قدرت انجام میدهد؟
وظیفه اصلی یادگیری ماشین این است که از روی نمونههای ورودی، یک مدل بسازد. سپس از همین مدل برای پیشبینی رفتار آینده دادهها یا برای تصمیمگیری بر اساس الگوهای مشاهدهشده استفاده میکنند. تفاوت مهم این رویکرد با بسیاری از روشهای کلاسیک در این است که لازم نیست همه روابط پیچیده شبکه را بهصورت صریح و دستی فرمولبندی کنیم؛ مدل میتواند این روابط را از دل دادهها یاد بگیرد.
البته این به معنای کنار گذاشتن مهندسی سیستم قدرت نیست. برعکس، بهترین نتایج زمانی به دست میآیند که دانش مهندسی با روشهای دادهمحور ترکیب شود. برای نمونه، در پیشبینی نیاز تولید برق، اگر دادههای مصرف گذشته، الگوهای زمانی، شرایط بهرهبرداری و محدودیتهای شبکه را همزمان وارد مدل کنیم، میتوان توان موردنیاز را با دقتی نزدیک به مصرف واقعی برآورد کرد.
چنین سامانههای پیشبینی تولید یا بار در پژوهشهای مختلف پیشنهاد شدهاند. ارزش عملی آنها زمانی بیشتر میشود که شبکه بخواهد تولید را تا حد ممکن متناسب با تقاضای واقعی تنظیم کند؛ نه آنقدر کم که خطر کمبود ایجاد شود و نه آنقدر زیاد که هزینه بهرهبرداری را بالا ببرد.
امنیت سیستم قدرت یعنی چه و چرا در این بحث مهم است؟
بهرهبرداری موفق از شبکه برق بدون مدیریت امنیت امکانپذیر نیست. امنیت سیستم قدرت به توانایی شبکه برای ادامه خدمترسانی، با وجود اغتشاشهای محتمل، اشاره دارد. این اغتشاشها همیشه قابل پیشبینی نیستند و در بسیاری از موارد ماهیتی تصادفی دارند. همین ویژگی، طراحی راهبردهای کنترل را دشوار میکند.
در عمل، برای حفظ امنیت، معمولاً از دو راهبرد مکمل استفاده میکنند: کنترل پیشگیرانه و کنترل اضطراری. این دو راهبرد هدف مشترکی دارند، اما منطق اجرایی آنها متفاوت است.
کنترل پیشگیرانه چیست؟
کنترل پیشگیرانه (Preventive Control) پیش از وقوع اغتشاش انجام میشود. اپراتورهای انسانی معمولاً این کار را انجام میدهند تا شبکه را در وضعیتی نگه دارند که بتواند اغتشاشهای محتمل را تحمل کند. به بیان ساده، اپراتور با تنظیمات بهرهبرداری، حاشیه امنیت لازم را حفظ میکند.
اما این رویکرد هزینه دارد. چون اغتشاشها ذاتاً تصادفیاند، کنترل پیشگیرانه همیشه باید میان دو عامل موازنه برقرار کند: از یک سو هزینه اقتصادی بهرهبرداری عادی، و از سوی دیگر ریسک ناپایداری یا ناامنی. اگر شبکه را بیش از حد محافظهکارانه بهرهبرداری کنیم، هزینه بالا میرود. اگر هم بیش از حد فشرده بهرهبرداری کنیم، احتمال ناپایداری افزایش مییابد.
کنترل اضطراری چیست؟
کنترل اضطراری (Emergency Control) پس از وقوع اغتشاش وارد عمل میشود و معمولاً ماهیتی خودکار دارد. مأموریت آن این نیست که حادثه را بهطور کامل حذف کند، بلکه باید شدت پیامدهای ناپایداری را کاهش دهد. در چنین شرایطی، زمان واکنش بسیار محدود است و تصمیم انسانی بهتنهایی کفایت نمیکند.
به همین دلیل، در صنعت برق مدرن، با افزایش فشار رقابتی و رشد فناوریهای ارتباطی و محاسباتی، گرایش به استفاده از کنترل اضطراری بیشتر شده است. شبکههای امروز نسبت به گذشته بیش از پیش به تصمیمگیری خودکار و سریع تکیه میکنند، بهویژه وقتی چند رخداد همزمان یا پشتسرهم رخ میدهد.
چالش اصلی در طراحی کنترل اضطراری
طراحی کنترل اضطراری فقط به داشتن یک منطق قطع و وصل محدود نمیشود. چالش اصلی این است که معیار مناسبی تعریف کنیم تا بتوانیم در زمان واقعی تشخیص دهیم آیا سیستم در مسیر از دست دادن پایداری قرار گرفته است یا نه.
این مسئله دو بخش مهم دارد. نخست، باید مشخص کنیم کدام اندازهگیریهای بلادرنگ واقعاً مفیدند، چون در شبکه تعداد زیادی کمیت قابل اندازهگیری وجود دارد. دوم، باید این اندازهگیریها را بهگونهای با هم ترکیب کنیم که یک قاعده تشخیص قابل اتکا شکل بگیرد.
اینجاست که یادگیری ماشین برتری خود را نشان میدهد. الگوریتم میتواند از میان تعداد زیادی ورودی، الگوهایی را پیدا کند که برای تشخیص آغاز ناپایداری، معنادارتر از بقیهاند. البته اگر دادههای آموزش را نادرست انتخاب کنیم، مدل ممکن است در رخدادهای واقعی دچار خطا شود. بنابراین، کیفیت داده و تعریف درست مسئله، بهاندازه انتخاب الگوریتم اهمیت دارد.
چرا شبیهسازی عددی پایه توسعه مدلهای یادگیری ماشین است؟
در سیستم قدرت، نمیتوان همه حالتهای بحرانی را از دادههای واقعی استخراج کرد. خوشبختانه فرایند طراحی کنترلهای اضطراری بهطور اساسی بر شبیهسازی عددی شبکه در شرایط مختلف تکیه دارد؛ بهویژه در شرایطی که ممکن است سیستم را به سمت ناپایداری سوق دهند.
این شبیهسازیها به مهندس اجازه میدهند سناریوهای متنوعی را بررسی کند: تغییر بار، خروج تجهیز، خطای سهفاز، تأخیر در عملکرد حفاظت یا ترکیب چند رخداد. هرچه تعداد سناریوها بیشتر باشد، پایگاه داده غنیتری برای آموزش مدل هوشمند ایجاد میشود.
بهدلیل رشد سریع توان محاسباتی، امروزه میتوان از روشهایی مانند نمونهبرداری مونتکارلو (Monte-Carlo Sampling) برای غربالگری تعداد بسیار بزرگی از شبیهسازیهای مقیاس بزرگ استفاده کرد. در چنین فرایندی، اجرای چند هزار شبیهسازی دیگر دور از دسترس نیست و همین موضوع، دیتاستهای بزرگی از نتایج عملکرد شبکه ایجاد میکند.
این پایگاههای داده فقط برای آرشیو نیستند. برعکس، میتوان آنها را با روشهای یادگیری خودکار تحلیل کرد تا اطلاعات مفیدی از دل آنها بیرون بیاید؛ اطلاعاتی مانند مرزهای پایداری، الگوهای منتهی به فروپاشی یا شاخصهایی که بهترین قدرت تفکیک بین حالت امن و ناامن را دارند.
ترکیب دادهکاوی و مهندسی قدرت: چیزی فراتر از پیشبینی ساده
گاهی تصور میشود یادگیری ماشین در صنعت برق فقط برای پیشبینی بار یا تولید به کار میرود. این تصور ناقص است. در واقع، کاربرد اصلی آن در بسیاری از مطالعات سیستم قدرت، تحلیل دادههای پیچیده برای استخراج قواعد تصمیم است؛ بهخصوص در جایی که روابط میان متغیرها بسیار غیرخطی یا چندبعدی هستند.
برای مثال، تشخیص اینکه یک شبکه در آستانه از دست دادن پایداری قرار دارد، معمولاً با یک متغیر واحد ممکن نیست. ممکن است الگوی همزمان ولتاژها، توانهای عبوری، وضعیت کلیدزنی و پاسخ دینامیکی برخی نواحی شبکه فقط در کنار هم معنا پیدا کنند. مدل یادگیری ماشین میتواند این ترکیب پیچیده را بهتر از قواعد دستی و ساده استخراج کند.
با این حال، هرجا دادهها نماینده واقعیت نباشند، نتایج هم گمراهکننده میشوند. بنابراین، در پروژههای عملی باید به این موارد دقت کرد:
- سناریوهای آموزش باید هم رخدادهای محتمل و هم رخدادهای بحرانی را پوشش دهند.
- متغیرهای ورودی باید از نظر فیزیکی معنا داشته باشند و صرفاً بهدلیل در دسترس بودن انتخاب نشوند.
- دادههای شبیهسازی و دادههای واقعی، در صورت امکان، باید با یکدیگر مقایسه و کالیبره شوند.
- معیار موفقیت مدل نباید فقط دقت آماری باشد؛ سرعت، قابلیت توضیحپذیری و پایداری عملکرد هم اهمیت دارند.
مزیتهای واقعی یادگیری ماشین در بهرهبرداری شبکه
اگر از ابزار هوشمند بهدرستی استفاده کنیم، چند منفعت کلیدی به دست میآید. اول، خطاهای ناشی از تفسیر انسانی در شرایط پیچیده کمتر میشود. دوم، سرعت تحلیل بالا میرود و تصمیمگیری در محیط بلادرنگ عملیتر میشود. سوم، شبکه میتواند در شرایط گذرا و اضطراری پاسخ دقیقتری بدهد.
علاوه بر این، یادگیری ماشین به حل مسائل پیچیده تحلیل داده هم کمک میکند. هرجا با حجم بزرگی از داده روبهرو باشیم و نتوانیم روابط پنهان آن را با روشهای ساده استخراج کنیم، مدلهای دادهمحور ارزش خود را نشان میدهند. این دقیقاً همان وضعیتی است که امروز در بسیاری از شبکههای تولید، انتقال و توزیع مشاهده میشود.
چه زمانی نباید از یادگیری ماشین انتظار معجزه داشت؟
یادگیری ماشین جایگزین کامل مدلسازی فیزیکی نیست. اگر دادهها کم، سوگیرانه یا بیکیفیت باشند، حتی پیچیدهترین مدلها هم نتیجه قابل اتکایی نخواهند داد. همچنین در مسائلی که قوانین فیزیکی روشن و سادهاند، گاهی روشهای کلاسیک سریعتر، شفافتر و کمهزینهتر عمل میکنند.
از طرف دیگر، در کاربردهای حساسی مانند کنترل اضطراری، صرف داشتن یک مدل دقیق کافی نیست. مدل باید در زمان محدود اجرا شود، در برابر نویز مقاوم باشد و روی دادههای خارج از مجموعه آموزش نیز رفتار قابل قبول نشان دهد. پس باید یادگیری ماشین را بر اساس نیاز واقعی مسئله انتخاب کرد، نه صرفاً بهخاطر جذابیت فناوری.
نقشه راه عملی برای استفاده از یادگیری ماشین در مطالعات سیستم قدرت
اگر یک تیم مهندسی بخواهد از یادگیری ماشین در مطالعات سیستم قدرت استفاده کند، بهتر است کار را مرحلهبهمرحله پیش ببرد. تجربه نشان میدهد این ترتیب، ریسک پروژه را کاهش میدهد:
- تعریف دقیق مسئله: پیشبینی بار، تشخیص ناپایداری، طبقهبندی رخداد یا پشتیبانی از تصمیم بهرهبردار.
- مشخص کردن منبع داده: اسکادا، ثبت خطا، اندازهگیری پستها یا دادههای شبیهسازی.
- بررسی کیفیت داده: کامل بودن، نویز، نرخ نمونهبرداری و همزمانی زمانی.
- انتخاب ویژگیها: فقط دادههایی که از نظر فنی با مسئله مرتبطاند.
- تولید سناریوهای کافی با شبیهسازی عددی، بهویژه برای حالتهای نادر اما بحرانی.
- آموزش و ارزیابی مدل با معیارهایی فراتر از دقت، مانند سرعت پاسخ و نرخ خطای بحرانی.
- آزمایش مدل در شرایط نزدیک به بهرهبرداری واقعی پیش از استفاده عملی.
این رویکرد کمک میکند یادگیری ماشین از یک ابزار نمایشی، به یک سامانه مهندسی قابل اعتماد تبدیل شود.
جایگاه این بحث در مطالعات سیستم قدرت
مرور کاربردهای یادگیری ماشین در سیستم قدرت از همین نقطه آغاز میشود: شبکههای برق مدرن، دادهمحورتر، پیچیدهتر و سریعتر از گذشته شدهاند. بنابراین، ابزارهای هوشمند برای پیشبینی، تحلیل و کنترل، بهویژه در شرایط عدمقطعیت و اضطرار، دیگر یک انتخاب لوکس نیستند؛ بلکه بخشی از جعبهابزار مهندس قدرت به شمار میآیند.
در ادامه این بحث، ادبیات پژوهش معمولاً به سمت دستهبندی کاربردها، روشهای مورد استفاده و نتایج حاصل از مطالعات مختلف میرود. اما پیش از ورود به آن بخش، باید همین مبانی را دقیق فهمید: چرا حجم دادهها افزایش یافته، چرا امنیت شبکه پیچیدهتر شده، و چرا شبیهسازی گسترده و یادگیری خودکار در کنار هم قرار گرفتهاند.
پیشبینی تولید برق با دادههای عظیم و مدلهای یادگیری ماشین
در مرجع [۲]، سامانهای کارآمد برای پیشبینی تولید برق بر پایه یادگیری ماشین و کلانداده ارائه شده است. این مطالعه نشان میدهد میان مقدار برق تولیدی و میزان منابع مصرفی، رابطهای مستقیم وجود دارد. این منابع شامل زغالسنگ، گاز، هستهای، نفت، فرآوردههای نفتی و انرژیهای تجدیدپذیر هستند. بنابراین، هر تغییر در سبد سوخت میتواند مستقیماً بر برآورد تولید اثر بگذارد.
این پژوهش همچنین نشان میدهد پیشبینی تولید برق میتواند اطلاعاتی، هرچند تقریبی، درباره تقاضای توان فراهم کند. افزون بر این، این پیشبینی در تشخیص احتمال نیاز به افزایش واردات برق از کشورهای همسایه نیز مفید است. این موضوع برای برنامهریزی بهرهبرداری و هماهنگی منطقهای اهمیت زیادی دارد. در عمل، هرچه برآورد تولید دقیقتر باشد، اپراتور شبکه با اطمینان بیشتری تصمیم میگیرد.
با این حال، پیشبینی تولید برق کار سادهای نیست. دلیل اصلی، نیاز جدی به دقت بالا است. وقتی مجموعهدادهها بسیار بزرگ باشند، این دشواری بیشتر هم میشود. نویز زیاد و نوسانپذیری بالا نیز مسئله را پیچیدهتر میکنند. به همین علت، انتخاب مدل مناسب در کاربردهای یادگیری ماشین در سیستم قدرت مرحلهای حساس به شمار میآید.
برای حل مسئله پیشبینی برق، پژوهشگران روشهای مختلفی را بر پایه الگوریتمهای گوناگون یادگیری ماشین پیشنهاد کردهاند. این روشها شامل شبکههای عصبی فازی FNN، الگوریتم خاکستری GA، مدل مارکوف خاکستری GMM و رگرسیون بردار پشتیبان SVR هستند. بررسیها نشان دادهاند این مدلها از نظر کیفیت پیشبینی، نتایج چشمگیری داشتهاند. به بیان دیگر، هرکدام در شرایط مناسب میتوانند برای مدلسازی رفتار تولید مفید باشند.
نفوذ گسترده منابع انرژی تجدیدپذیر نیز عدم قطعیت تولید را افزایش داده است. نمونههای اصلی این منابع، باد و خورشید هستند. چون خروجی این منابع متغیر است، پیشبینی تولید برق اهمیت بیشتری پیدا میکند. این پیشبینی برای تخصیص درست منابع تولیدکننده توان و برآورد میزان واردات از نواحی مجاور، نقشی تقریباً حیاتی دارد. در نتیجه، تحلیل دادهمحور به بخشی ضروری از بهرهبرداری تبدیل شده است.
پایش، عیبیابی و برآورد عمر ترانسفورماتورهای قدرت
در مرجع [۳] آمده است که ترانسفورماتورهای قدرت از گرانترین و حیاتیترین تجهیزات شبکه به شمار میروند. بنابراین، توسعه روشهای مؤثر برای پایش و تشخیص وضعیت عایقی آنها ضروری است. خرابی این تجهیز فقط هزینه تعمیر ایجاد نمیکند، بلکه میتواند بهرهبرداری شبکه را نیز مختل کند. به همین دلیل، تشخیص زودهنگام افت کیفیت عایق اهمیت عملی زیادی دارد.
این مطالعه اشاره میکند که شرکتهای برق در سالهای اخیر چندین تکنیک را برای تشخیص وضعیت ترانسفورماتورها به کار گرفتهاند. این تکنیکها شامل تحلیل گازهای محلول DGA، اندازهگیری جریانهای پلاریزاسیون و دپلاریزاسیون PDC و طیفسنجی حوزه فرکانس FDS هستند. با این همه، هنوز یک چالش مهم باقی مانده است: ارتباطدادن دادههای اندازهگیریشده به وضعیت واقعی عایق ترانسفورماتور. یعنی داده وجود دارد، اما تفسیر آن همیشه مستقیم و ساده نیست.
برای رفع این مشکل، پژوهشگران در همان مطالعه الگوریتمهای یادگیری ماشین، شامل نقشههای خودسازمانده SOM و ماشین بردار پشتیبان SVM، را توسعه دادند. هدف آنها تحلیل خودکار دادههای اندازهگیری و عیبیابی عایق ترانسفورماتور بود. مزیت اصلی این الگوریتمها، یادگیری وابستگیهای آماری پنهان میان دادههای بایگانیشده و وضعیت ترانسفورماتورهای متناظر است. سپس همین دانش آموختهشده به تشخیص عایق کمک میکند.
در مرجع [۴] نیز پیشبینی عمر ترانسفورماتور قدرت بر پایه یادگیری ماشین مطرح شده است. پیشبینی عمر باقیمانده ترانسفورماتورهای فشارقوی برای شرکتهای انرژی اهمیت زیادی دارد. دلیل این اهمیت، نیاز به برنامهریزی تعمیرات و مدیریت مخارج سرمایهای است. وقتی اپراتور بداند هر تجهیز چهقدر عمر مفید دارد، میتواند زمان تعویض یا تعمیر را دقیقتر تعیین کند.
در این مطالعه، پژوهشگران مدلهای یادگیری ماشین را برای تحلیل ترانسفورماتورها و پیشبینی طول عمر آنها به کار بردند. نتایج نشان داد ترکیب مدلهای یادگیری ماشین با مدلهای تجربی، برآورد عمر ترانسفورماتور را بهبود میدهد. همچنین، یک مدل پارامتری عمر برای پیشبینی توزیع طول عمر هر ترانسفورماتور استفاده شد. افزون بر این، پژوهشگران یک رویه آماری برای محاسبه عمر باقیمانده ترانسفورماتورهای در حال بهرهبرداری توسعه دادند.
یکی از نکات کاربردی این رویکرد، اطلاعرسانی پیشدستانه است. با استفاده از الگوریتمهای یادگیری ماشین، مقادیر تلفات ترانسفورماتور را پیش از بروز آسیب، از طریق ایمیل یا دیگر ابزارهای ارتباطی برای کاربران نهایی ارسال میکنند. در نتیجه، کاربران از عمر باقیمانده تجهیز آگاه میشوند. این هشدار میتواند با فراهمکردن زمینه نگهداری مناسب و بهموقع، از شکست ترانسفورماتور جلوگیری کند.
یادگیری تقویتی برای کنترل سیستم قدرت
در مرجع [۵]، نوعی الگوریتم جدید یادگیری تقویتی با نام fitted Q iteration برای طراحی برخی عاملهای هوشمند کنترل سیستم قدرت بررسی شده است. ویژگی اصلی این الگوریتم، تبدیل مسئله یادگیری تقویتی به دنبالهای از مسائل استاندارد یادگیری نظارتشده است. این ویژگی اهمیت دارد، چون استفاده از ابزارهای جاافتاده یادگیری نظارتشده را ممکن میکند. در نتیجه، فرایند طراحی کنترلگر میتواند ساختیافتهتر پیش برود.
گزارشها نشان میدهند fitted Q iteration به دلیل توانایی تعمیم اطلاعات، ظرفیت مناسبی برای حل مسائل واقعی کنترل در سیستم قدرت دارد. همچنین، پژوهشگران دو مسئله را برای دورزدن مشکلات مرتبط با بهکارگیری fitted Q algorithm شناسایی کردند. هرچند متن منبع جزئیات این دو مسئله را باز نمیکند، اصل موضوع روشن است. یعنی اگر بخواهیم از این الگوریتم در عمل استفاده کنیم، باید محدودیتهای آن را در سناریوهای واقعی مدیریت کنیم.
نتایج شبیهسازی این پژوهش امیدبخش بودهاند. این نتایج از یک راهبرد کنترل بلادرنگ برای TCSC پشتیبانی میکنند. TCSC یا خازن سری کنترلشونده با تریستور، در یک سیستم قدرت چهارماشینه نصب شده بود. هدف، کنترل برخط این تجهیز بود. چنین نتیجهای نشان میدهد یادگیری تقویتی میتواند از سطح نظری فراتر برود و به لایه کنترل دینامیکی نزدیک شود.
دادههای ریزدانه، یادگیری عمیق و تصمیمگیری نزدیک به زمان واقعی
در مرجع [۶] آمده است که سیستمهای قدرت مدرن، با نفوذ بیشتر تولید تجدیدپذیر و مشارکت بالاتر سمت تقاضا، با پیچیدگی و عدم قطعیت فزاینده روبهرو هستند. از سوی دیگر، بهرهبرداری قابل اعتماد شبکه به روشهای بهتر برای مدلسازی، ارزیابی و تصمیمگیری نیاز دارد. بنابراین، صرف افزایش داده کافی نیست. باید الگوریتمی هم وجود داشته باشد که این داده را به تصمیم عملیاتی تبدیل کند.
امروزه اپراتورهای سیستم با کمک کنتورهای هوشمند و فناوریهای پیشرفته حسگری، به دادههای برق با دقت زمانی بالا دسترسی دارند. با این وجود، هنوز به الگوریتمهای کارا و نزدیک به زمان واقعی برای تحلیل این دادهها نیاز فوری وجود دارد. این الگوریتمها باید بتوانند از دادههای موجود استفاده بهتری ببرند. در غیر این صورت، حجم زیاد اطلاعات فقط بار محاسباتی ایجاد میکند.
پیشرفتهای اخیر در الگوریتمهای یادگیری ماشین، بهویژه جهشهای بزرگ در یادگیری عمیق، این حوزه را به ابزاری مناسب برای حل مسائل دادهمحور سیستم قدرت تبدیل کرده است. برای نمونه، شبکههای عصبی بازگشتی RNN میتوانند در پیشبینی توان بادی، توان خورشیدی و بار ساختمانها کاربرد مستقیم داشته باشند. این مثالها نشان میدهند میتوان الگوهای زمانی پیچیده را با مدلهای توالیمحور بهتر استخراج کرد.
کاربردهای گزارششده فقط به پیشبینی محدود نمیشوند. یادگیری ماشین در آشکارسازی خاموشیهای شبکه نیز به کار رفته است. همچنین، میتوان مسائل کنترل HVAC و تدوین سیاستهای حفاظت شبکه را با رویکردهای یادگیری ماشین حل کرد. این گستره کاربرد، نقش فزاینده یادگیری ماشین در سیستم قدرت را در لایههای مختلف شبکه نشان میدهد؛ از تحلیل تا کنترل و حفاظت.
امنیت، پایداری و محدودیتهای عملی روشهای یادگیری ماشین
در مرجع [۷] گزارش شده است که افزایش استفاده از انرژیهای تجدیدپذیر، آزادسازی بازار انرژی و مهمتر از همه، یکپارچهسازی زیرساختهای پایش، اندازهگیری و ارتباطات در شبکههای مدرن، فرصت ساخت یک شبکه برق تابآور و کارا را در سطوح مختلف ولتاژ فراهم کرده است. با این حال، همین پیچیدگی تهدیدهای جدیدی هم ایجاد میکند. بنابراین، باید در کنار بهرهوری، نگاه امنیتی و پایداری را نیز جدی گرفت.
از جمله تهدیدهای مطرحشده، حملات سایبری، ناپایداری ولتاژ و اغتشاشات کیفیت توان PQ هستند. این موارد میتوانند امنیت و پایداری شبکههای پیچیده را تضعیف کنند. در این فضا، تکنیکهای یادگیری ماشین مانند شبکههای عصبی مصنوعی ANN، درخت تصمیم DT و ماشین بردار پشتیبان SVM را برای تصمیمگیری مؤثر و اجرای اعمال کنترلی در بهرهبرداری امن و پایدار سیستم قدرت به کار گرفتهاند. یعنی یادگیری ماشین فقط ابزار پیشبینی نیست، بلکه ابزار اقدام هم هست.
این مقاله مروری جامع از جدیدترین مطالعاتی ارائه میکند که در آنها فناوریهای یادگیری ماشین را برای امنیت و پایداری سیستم قدرت توسعه دادهاند. تمرکز ویژه آن بر تشخیص حملات سایبری، مطالعات اغتشاشات کیفیت توان و ارزیابی امنیت دینامیکی است. هدف مطالعه، برجستهکردن روششناسیها، دستاوردها و مهمتر از آن، محدودیتهای موجود در طراحی دستهبند، مجموعهداده و سیستمهای آزمون استفادهشده در مقالات مرورشده است.
همچنین، مروری کوتاه بر رویکردهای یادگیری تقویتی RL و یادگیری تقویتی عمیق DRL برای ارزیابی پایداری گذرا ارائه شده است. با وجود دستاوردهای چشمگیر در بررسیهای امنیت و پایداری، پژوهش به یک شکاف تحقیقاتی مهم اشاره میکند. این شکاف نشان میدهد هنوز تعدادی چالش اساسی حل نشدهاند. بنابراین، این حوزه هنوز به بلوغ کامل کاربردی نرسیده است.
نخستین چالش مهم، وابستگی شدید دقت پیشبینی و تشخیص به کیفیت و کمیت مجموعهداده و سیستمهای آزمون است. اما گاهی به دلیل نبود یا ناکافیبودن سیستمهای قدرت واقعی، دادههای نیروگاههای واقعی و تجهیزات میدانی در دسترس نیستند. در نتیجه، پژوهشگران ناچار میشوند به استفاده از دادههای شبیهسازیشده و توسعه بسترهای آزمون مقیاسپذیر تکیه کنند. این مسئله به ناسازگاری در پیشبینی و طبقهبندی منجر شده است.
عامل مهم دیگر، تنظیم پارامترها است. این موضوع یکی از ویژگیهای خاص کاربردهای یادگیری ماشین به شمار میرود. فرایندهای سنگین و دقیق تنظیم پارامتر برای رسیدن به نتیجه مطلوب، نشان میدهد رویکردهای فناوری یادگیری ماشین به سطح بالایی از تعامل کارشناس نیاز دارند. علاوه بر این، این رویکردها گاهی زمانبر هستند. بنابراین، باید هم هزینه محاسباتی و هم هزینه تخصص انسانی را در نظر گرفت.
چالش بعدی به دادههای PMU مربوط میشود. بسیاری از مقالات فرض میکنند دادههای PMU کامل، دقیق و برای استفاده برخط در دسترس هستند. اما در عمل، اندازهگیریها همیشه در دسترس نیستند. اختلال، خرابی و حمله میتوانند دسترسی به این دادهها را مختل کنند. ازاینرو، باید اعتبار مدل را در محیط واقعی با فرض داده ناقص نیز بررسی کرد.
در پایان، پیشنهاد شده است که پژوهشهای آینده در رویکردهای مبتنی بر فناوری یادگیری ماشین برای امنیت و پایداری سیستم قدرت، بر اعتبارسنجی دقیق با استفاده از سیستمهای آزمون بزرگمقیاس متمرکز شوند. این سیستمها باید ویژگیهایی مشابه سیستمهای قدرت مدرن داشته باشند. تنها در این صورت میتوان به انتقال مطمئن نتایج از محیط پژوهش به شبکه واقعی نزدیک شد.
پایش بلادرنگ و طبقهبندی خطا در شبکههای هوشمند
در مرجع [۸] مشخص شده است که سیستمهای قدرت مدرن برای حفاظت در برابر خطاهای خطوط انتقال، به پایش بلادرنگ و کنترل سریع نیاز دارند. با واقعیشدن شبکه هوشمند، نصب حسگرهای باکیفیت مانند واحدهای پایانه دوردست، واحدهای اندازهگیری فازور، کنتورهای هوشمند و دیگر تجهیزات اندازهگیری، حجم بزرگی از دادههای ناهمگن تولید میکند. این دادهها برای کنترل عملیاتی و تحلیل عملکرد شبکه ضروری هستند.
در چنین محیطی، روشهای متداول حوزه زمان از نظر محاسباتی به ناکارآمدی گرایش دارند. همچنین، ممکن است نتوانند الزامات کاربردهای بلادرنگ را برآورده کنند. در مقابل، الگوریتمهای یادگیری ماشین میتوانند بدون برنامهنویسی مستقیم، از روی دادهها یاد بگیرند. سپس وقتی مدل با داده جدید روبهرو میشود، میتواند بهصورت مستقل پاسخ دهد. این ویژگی برای سامانههای حفاظتی بسیار ارزشمند است.
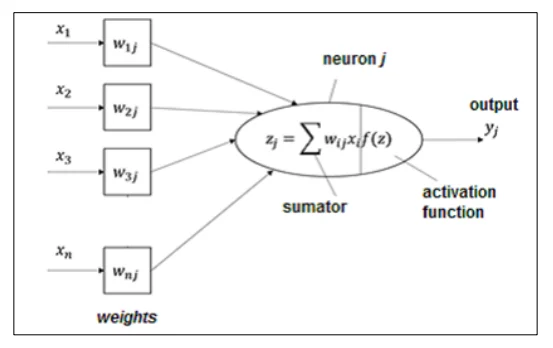
رویکردهای یادگیری ماشین مانند شبکههای عصبی مصنوعی ANN، درختهای تصمیم DT و مدلهای یادگیری عمیق DLM میتوانند اطلاعات مفیدی درباره ایمنی در سیستمهای قدرت فراهم کنند. بر همین اساس، مقاله یک روش مبتنی بر یادگیری ماشین برای طبقهبندی و تشخیص خطا در سیستمهای قدرت پیشنهاد کرده است. همچنین، مطالعه فهرستی از تکنیکهای یادگیری ماشین برای طبقهبندی خطا ارائه میدهد. این فهرست مسیر انتخاب روش متناسب با نوع خطا و محدودیتهای داده را روشنتر میکند.
الگوریتمهای رایج برای تشخیص و مکانیابی خطا
در این حوزه، چند روش پرکاربرد بارها گزارش شدهاند و همین روشها مبنای بخش بزرگی از مطالعات یادگیری ماشین در سیستم قدرت را تشکیل میدهند.
- ماشین بردار پشتیبان
- یادگیرنده بیزی
- بهینهسازی کمینه ترتیبی
- رگرسیون لجستیک
- درخت تصمیم
- نزدیکترین همسایه K
این فهرست نشان میدهد پژوهشگران از مدلهای خطی، احتمالاتی، درختی و مبتنی بر فاصله استفاده کردهاند. بنابراین، انتخاب روش به نوع داده، هدف مطالعه و میزان دقت موردنیاز بستگی دارد.
مطالعه تشخیص و مکانیابی خطا در خط انتقال ۶۰۰ کیلومتری
در مرجع [۹]، پژوهشگران چهار تکنیک قدرتمند و پرطرفدار یادگیری ماشین را برای شناسایی و مکانیابی خطا معرفی کردند. این چهار روش شامل طبقهبند Bagging، طبقهبند Boosting، طبقهبند تابع پایه شعاعی یا RBF و طبقهبند بیز ساده یا NBC بود.
این مطالعه روی یک خط انتقال به طول ۶۰۰ کیلومتر انجام شد. همچنین، پژوهشگران در این بررسی ۱۱ نوع خطا را شناسایی، پیشبینی و مکانیابی کردند.
نتایج آزمایش نشان داد RBF، Bagging و NBC برای پیشبینی نوع خطا مناسباند. علت این برتری، دقت بالای این روشها در تشخیص نوع خطا بود.
با این حال، در آزمایش پیشبینی محل خطا، دقت نتایج به اندازه پیشبینی نوع خطا نبود. با وجود این محدودیت، RBF، NBC و Bagging همچنان بالاترین دقت را در مکانیابی خطا بهدست آوردند.
در نهایت، پژوهشگران گزارش کردند که تکنیکهای یادگیری ماشین برای شناسایی خطاهای خط انتقال کاربردی هستند. البته، دقت مکانیابی هنوز باید بهتر شود تا بتوان محل خطا را دقیقتر تعیین کرد.
مرور جامع روشهای تشخیص، طبقهبندی و مکانیابی خطا
در مرجع [۱۰]، یک مرور جامع از روشهای تشخیص، طبقهبندی و مکانیابی خطا در خطوط انتقال ارائه شد. پیش از معرفی این روشها، نویسندگان مروری بر تکنیکهای استخراج ویژگی انجام دادند.
آنها همچنین مبانی الگوریتمهای شناسایی خطا را بررسی کردند. در کنار آن، تبدیلهای مختلف و روشهای کاهش بُعد نیز مورد بحث قرار گرفت.
این مقاله ایدههای جدید توسعهیافته را هم بررسی کرد. افزون بر این، نویسندگان این ایدهها را با برخی جنبههای مهم تشخیص خطا مقایسه کردند.
این مرور نشان داد که پژوهشگران بهطور گسترده از روشهای یادگیری ماشین برای طبقهبندی نوع خطا استفاده میکنند. در کنار ماشین بردار پشتیبان، چند روش دیگر نیز برای این کار توصیه شدهاند.
این روشها شامل سیستم استنتاج فازی، شبکههای عصبی مصنوعی، درخت تصمیم و الگوریتمهای مبتنی بر یادگیری عمیق بودند. در میان روشهای عمیق نیز شبکه عصبی کانولوشنی و یادگیری ماشین مبتنی بر Restricted Boltzmann Machine پیشنهاد شد.
الگوریتمهای یافتن محل خطا نیز همراه با روشهای مبتنی بر هوش مصنوعی بررسی شدند. افزون بر این، نویسندگان برای روشهای آینده مکانیابی خطا، یادگیری عمیق را توصیه کردند.
دلیل این توصیه، افزایش نقش ارتباطات و محاسبات در سیستمهای انتقال است. هرچه سامانه انتقال هوشمندتر و متصلتر شود، ارزش مدلهای عمیق نیز بیشتر خواهد شد.
نقش شبکههای عصبی در تشخیص، طبقهبندی و مکانیابی خطا
استفاده از ANN در سیستم تست WSCC ۹-Bus
در مرجع [۱۱]، تمرکز پژوهش بر تشخیص، طبقهبندی و مکانیابی خطا در یک سیستم قدرت با استفاده از شبکههای عصبی مصنوعی بود. در این مطالعه، پژوهشگران از شبکههای عصبی پیشخور استفاده کردند.
آنها این شبکهها را با الگوریتم پسانتشار خطا آموزش دادند. برای اعتبارسنجی سامانه پیشنهادی نیز سیستم تست ۹ شینه WSCC را در MATLAB/SIMULINK مدلسازی کردند.
نتایج شبیهسازی نشان داد ANNها میتوانند برای تشخیص، طبقهبندی و مکانیابی خطا بهکار روند. همچنین، این نتایج نشان دادند که شبکهها حتی در نقاطی که برای آنها آموزش ندیدهاند نیز تا حدی عملکرد مناسبی دارند.
با این حال، تعداد نورونهای لایه پنهان باید بر اساس نوع خطا انتخاب شود. این موضوع مستقیماً بر کیفیت تشخیص و مکانیابی اثر میگذارد.
برای خطای تکفاز به زمین، کمترین تعداد نورون در لایه پنهان کافی است. در این حالت، تنها پنج شبکه برای تشخیص و مکانیابی قابل استفاده بودند.
برای تشخیص، مکانیابی و طبقهبندی خطاهای دوفاز و دوفاز به زمین، دستکم ۱۰ نورون در لایه پنهان لازم بود. بنابراین، هرچه پیچیدگی خطا بیشتر میشد، شبکه نیز به ظرفیت بیشتری نیاز داشت.
برای خطاهای سهفاز، شبکه عصبی به ۳۰ تا ۳۵ نورون در لایه پنهان نیاز داشت. همچنین گزارش شد که افزایش بیشتر تعداد نورونهای لایه پنهان به بهبود نتایج منجر نشد.
طبقهبندی خودکار اغتشاش با یادگیری عمیق و دادههای PMU
در مرجع [۱۲]، گزارش شد که حجم زیاد دادهها کاربرد چارچوبهای یادگیری عمیق را گسترش داده است. این گسترش بهویژه در طبقهبندی خودکار اغتشاشها دیده میشود.
برای این هدف، پژوهشگران از مجموعهای از اندازهگیریهای چند واحد اندازهگیری فازوری استفاده کردند. این PMUها در بخشهای ولتاژ پایین یک سیستم بههمپیوسته نصب شده بودند.
آنها از این دادهها الگوهای نماینده استخراج کردند. سپس این الگوها را برای آشنا کردن طبقهبند با دانش مرتبط با اغتشاشهای سیستم بهکار گرفتند.
راهبردهای بهکاررفته شامل پرسپترون چندلایه، شبکههای Deep Belief و شبکههای CNN بودند. در میان آنها، CNN از نظر دقت طبقهبندی عملکرد بهتری نسبت به بقیه نشان داد.
علاوه بر دقت، سرعت اجرا نیز بررسی شد. به همین دلیل، این معماریها را هم روی CPU و هم روی GPU پیادهسازی کردند تا میزان سود حاصل از افزایش سرعت مشخص شود.
تشخیص و طبقهبندی خطا در خط انتقال سهفاز با ANN
در مرجع [۱۳]، کاربرد شبکههای عصبی مصنوعی برای تشخیص و طبقهبندی خطا در یک سیستم خط انتقال سهفاز ارائه شد. روش توسعهیافته از ولتاژهای سهفاز و جریانهای سهفاز بهعنوان ورودی شبکه استفاده میکرد.
این ورودیها را نسبت به مقادیر پیش از وقوع خطا نرمالسازی کردند. در نتیجه، اثر مقیاس سیگنال کاهش یافت و مقایسه حالتها آسانتر شد.
نتایج بهدستآمده فقط به خطاهای فاز به زمین مربوط بودند. همچنین، معماری شبکه عصبی بهکاررفته در این مطالعه از نوع پسانتشار بود.
نتایج شبیهسازی نشان داد همه شبکههای پیشنهادی عملکرد رضایتبخشی دارند. افزون بر آن، این شبکهها از نظر عملی نیز قابل پیادهسازی هستند.
این مطالعه بر اهمیت انتخاب مناسبترین پیکربندی ANN تأکید کرد. زیرا بهترین عملکرد تنها زمانی بهدست میآید که ساختار شبکه بهدرستی انتخاب شده باشد.
جمعبندی نتایج کلیدی پژوهشها
از مجموعه این پژوهشها، چند نتیجه مهم بهدست میآید. این نتایج برای استفاده عملی از یادگیری ماشین در سیستم قدرت اهمیت زیادی دارند.
- شبکههای عصبی مصنوعی، روشی قابلاعتماد و مؤثر برای تشخیص و طبقهبندی خطا در خطوط انتقال هستند. این مزیت با افزایش اتصالپذیری پویای سامانههای انتقال مدرن اهمیت بیشتری پیدا میکند.
- عملکرد ANN را باید با دقت تحلیل کرد. بهویژه، پیش از انتخاب برای کاربرد عملی، لازم است ساختار شبکه عصبی و الگوریتم یادگیری بهخوبی ارزیابی شوند.
- شبکههای عصبی مبتنی بر پسانتشار، وقتی با مجموعهدادههای آموزشی بزرگ آموزش میبینند، عملکرد خوبی ارائه میدهند. چنین دادههایی معمولاً در سیستمهای قدرت بهراحتی در دسترس هستند.
تشخیص، طبقهبندی و مکانیابی خطا با ترکیب موجک و مدلهای هوشمند
در مرجع [۱۴]، روشی برای تشخیص و طبقهبندی خطا در سیستمهای انتقال ارائه شده است که مقدار منفرد موجک را با منطق فازی ترکیب میکند. به این ترتیب، روش بهطور همزمان از توان تفکیک سیگنال در حوزه زمان-فرکانس و قابلیت تصمیمگیری منطق فازی بهره میگیرد.
نتایج این مطالعه نشان میدهد شاخصهای پیشنهادی برای منطق فازی به تغییرات بسیار حساساند. در نتیجه، روش میتواند رخداد خطا را با دقت مناسبی آشکار کند. این حساسیت همچنین به واکنش سریعتر در برابر تغییرات ناشی از وقوع اغتشاش منجر میشود.
پژوهشگران گزارش کردهاند که این روش در برابر تغییر پارامترهای مهم خطا مقاوم است. این پارامترها شامل نوع خطا، محل شروع خطا، مقاومت خطا و زاویه توان میشوند. بنابراین، الگوریتم در شرایط کاری متفاوت نیز عملکردی پایدار حفظ میکند.
الگوریتم پیشنهادی در [۱۴] را بهعنوان روشی سریع و مناسب برای تشخیص و طبقهبندی خطا معرفی کردهاند. این روش در شرایط مختلف میتواند خطا را تشخیص دهد. افزون بر این، کمتر از ۱۰ میلیثانیه پس از شروع خطا، فاز سالم را از فاز معیوب تفکیک میکند.
ترکیب DWT و ANFIS برای حفاظت سریع خطوط انتقال
در مرجع [۱۵]، طرحی قابل اعتماد برای تشخیص، طبقهبندی و مکانیابی خطاهای خطوط انتقال توسعه یافته است. این طرح دو بخش کلیدی دارد: بخش نخست، استخراج ویژگی با تبدیل موجک گسسته است و بخش دوم، طبقهبندی هوشمند با سامانه استنتاج فازی-عصبی تطبیقی.
در این مطالعه، مدل DWT-ANFIS را پیادهسازی و آزمون کردهاند. سپس نتایج آن را با مدل Impedance-ANFIS مقایسه کردهاند. هدف از این مقایسه، سنجش مزیت استفاده از ویژگیهای موجکی در برابر روش مبتنی بر امپدانس بوده است.
نتایج نشان میدهد خطاها در مدت ۸ میلیثانیه تشخیص داده میشوند. این زمان از یک سیکل کامل پس از شروع خطا کمتر است. بنابراین، میتوان از آسیب به تجهیزات و نیز خاموشی طولانیمدت جلوگیری کرد.
تشخیص خطاهای شنت با ضرایب موجک و پنجره نیمسیکل
در مرجع [۱۶]، رویکردی مبتنی بر تبدیل موجک برای تشخیص و طبقهبندی انواع خطاهای شنت خطوط انتقال ارائه شده است. این روش بر تحلیل سیگنالهای جریان تمرکز دارد. هدف آن نیز شناسایی دقیق خطاهای محتمل در شبکه انتقال است.
الگوریتم این مطالعه عمدتاً به محاسبه مقدار RMS ضرایب موجک سیگنالهای جریان متکی است. این محاسبه را برای دو انتهای خط انتقال انجام میدهند. همچنین، طول پنجره متحرک را برابر با نیم سیکل در نظر گرفتهاند.
برای تحلیل سیگنالهای جریان، از موجک dB4 استفاده شده است. این تحلیل، ضرایب جزئیات را استخراج میکند. سپس، این ضرایب را با مقادیر آستانه مقایسه میکنند تا خطا تشخیص داده و طبقهبندی شود.
برای نشان دادن اثربخشی تکنیک پیشنهادی، شبیهسازیهای گستردهای انجام شده است. این شبیهسازیها با نرمافزارهای PSCAD/EMTDC و MATLAB انجام شدهاند. علاوه بر این، انواع مختلف خطا را با تغییرات گسترده در مقاومت، زاویه شروع و سطوح بار بررسی کردهاند.
نتیجه این مطالعه نشان میدهد تکنیکهای بررسیشده برای پیادهسازی در طرحهای حفاظت دیجیتال دیستانس مناسباند. این موضوع از نظر عملی اهمیت زیادی دارد. زیرا حفاظت دیستانس به تصمیمگیری سریع و پایدار در برابر شرایط متنوع نیاز دارد.
شناسایی خودکار نوع خطا با تحلیل گذرا و شبکه عصبی احتمالاتی
در مرجع [۱۷]، روشی برای خودکارسازی شناسایی خطا در سیستم قدرت ارائه شده است. این کار بر اطلاعات حاصل از تحلیل موجکی گذراهای سیستم قدرت تکیه دارد. همچنین، در این مطالعه از شبکه عصبی احتمالاتی یا PNN نیز استفاده شده است.
تمرکز اصلی این مطالعه بر شناسایی خطاهای ساده سیستم قدرت است. به همین دلیل، تحلیل را بر الگوهای مشخص و پایهای خطا انجام دادهاند. این رویکرد برای طراحی سامانههای حفاظتی خودکار بسیار مفید است.
در این پژوهش، تبدیل موجک اغتشاش گذرایی را که در اثر وقوع خطا ایجاد میشود نیز انجام دادهاند. سپس، ضرایب جزئیات را بررسی کردهاند. برای هر نوع خطای ساده، ضریب جزئیات ماهیتی مشخص و متمایز دارد.
برای تفکیک این ضرایب جزئیات، از شبکه PNN استفاده شده است. در نتیجه، نوع خطا را نیز میتوان از روی همان الگوها تشخیص داد. ترکیب تبدیل موجک با PNN برای تعیین نوع خطا و خودکارسازی این فرایند توانسته است برای همه انواع خطا به دقت ۱۰۰ درصد برسد.
در همین مطالعه، الگوریتم پسانتشار محدودیتهایی نشان داده است. این الگوریتم در تفکیک کامل خطاهای فاز به زمین و نیز خطاهای دو فاز به زمین موفق نبوده است. بنابراین، PNN در این کاربرد عملکرد بهتری داشته است.
سه وظیفه اصلی رلهگذاری خطوط انتقال
در مرجع [۱۸] آمده است که رلهگذاری خطوط انتقال سه وظیفه اصلی را در بر میگیرد. این سه وظیفه، هسته عملکرد هر سامانه حفاظتی خط را تشکیل میدهند.
- تشخیص خطا
- طبقهبندی خطا
- مکانیابی خطا
تشخیص و طبقهبندی خطا با دادههای نوساننگاری
در حفاظت خطوط انتقال، سه کار باید با بیشترین سرعت و دقت انجام شوند. انجام این کارها برای بیبرق کردن بخش خطادار ضروری است. بر همین مبنا، پژوهشگران روشی نو برای تشخیص و طبقهبندی خطای خط انتقال با استفاده از دادههای نوساننگاری پیشنهاد کردند. این روش، تصمیم تشخیص خطا و رفع آن را بر پایه مجموعهای از قواعد میگیرد. این قواعد نیز از تحلیل شکل موج جریان در حوزه زمان و حوزه موجک به دست میآیند.
مزیت مهم این روش، توانایی آن در جداسازی خطا از دیگر اغتشاشات کیفیت توان است. برای نمونه، افت ولتاژ و گذرای نوسانی در بهرهبرداری سیستم قدرت پدیدههایی رایج هستند. با این حال، روش پیشنهادی میتواند آنها را از خطا تفکیک کند. سپس یک شبکه عصبی مصنوعی، با شناسایی الگوی شکل موج جریان و ولتاژ در حوزه زمان، نوع خطا را تعیین میکند. گزارشها نشان میدهند که این روش را روی دادههای واقعی نوساننگاری یک شرکت برق برزیلی به کار بردهاند. نتایج نیز بسیار خوب بوده است.
مدل ANN برای خطوط ۳۳ کیلوولت نیجریه
در مطالعهای دیگر، پژوهشگران بر توسعه یک شبکه عصبی مصنوعی واحد برای تشخیص و طبقهبندی خطا تمرکز کردند. آنها این کار را روی خطوط انتقال ۳۳ کیلوولت نیجریه انجام دادند. این پژوهش از شبکه عصبی پیشخور با الگوریتم پسانتشار خطا استفاده کرد. هدف، ساخت یک آشکارساز-طبقهبند هوشمند برای خطا بود. همچنین، نتایج شبیهسازی را برای نشان دادن کارایی این سامانه ارائه کردند.
پژوهشگران عملکرد این آشکارساز-طبقهبند را با دو شاخص ارزیابی کردند. شاخص نخست، میانگین مربعات خطا یا MSE بود. شاخص دوم نیز ماتریس درهمریختگی بود. سامانه به MSE برابر با ۰.۰۰۰۰۴۲۷۹ رسید و دقت ۹۵.۷ درصدی را ثبت کرد. بنابراین، عملکرد سامانه هوشمند توسعهیافته را رضایتبخش ارزیابی کردند. همچنین، در مقایسه با سامانههای مشابهی که در ادبیات مربوط به خطوط انتقال نیجریه گزارش شدهاند، این سامانه عملکرد بهتری داشت.
یادگیری عمیق برای طبقهبندی بلادرنگ خطا
مطالعهای دیگر، امکان استفاده از معماری یادگیری عمیق مبتنی بر شبکه عصبی کانولوشنی را بررسی کرد. تمرکز این کار بر طبقهبندی بلادرنگ خطای سیستم قدرت بود. این پژوهش فقط طبقهبندی خطا را بررسی کرد و به مکانیابی خطا نپرداخت. هدف، طبقهبندی نمونههای سیگنال ولتاژ سیستم قدرت در زمان واقعی بود. سامانه باید مشخص میکرد هر نمونه به حالت خطادار تعلق دارد یا به حالت غیرخطادار.
پژوهشگران دادهها را با شبیهسازی یک سیستم قدرت ساده دوباسه و بار سهفاز متعادل تولید کردند. آنها سیگنال ولتاژ را در ابتدای خط میان دو باس اندازهگیری کردند. محل وقوع خطا نیز در نیمه طول خط بین همان دو باس قرار داشت. این چیدمان، سناریویی کنترلشده برای آموزش و آزمون مدل فراهم کرد. به این ترتیب، پژوهشگر توانست رفتار مدل را در شرایط مشخص ارزیابی کند.
در گام اول، تبدیل موجک را برای استخراج هارمونیکهای خطا به کار گرفتند. برای این منظور، از موجک مادر دابیشیز dB4 استفاده شد. سپس یک پنجره نمونه با اندازه ثابت را روی جزئیات موجک در سطح تجزیه ۴ حرکت دادند. این سطح، انتخابی مناسب به نظر میرسید. پس از نرمالسازی، نمونههای آموزشی تولیدشده را به شبکه عصبی کانولوشنی دادند تا فرایند یادگیری انجام شود.
شبکه CNN با نمونههای خطادار و غیرخطادار آموزش دید. به این ترتیب، ویژگیهای خطای سیستم قدرت را آموخت. در پایان، مدل نمونههای مجموعه آزمون را طبقهبندی کرد. جمعبندی پژوهش این بود که CNN میتواند ویژگیهای خطای سیستم قدرت را با موفقیت یاد بگیرد. همچنین، این شبکه توانست آنها را بهدرستی طبقهبندی کند. در برخی سناریوهای آموزشی، یعنی زمانی که مجموعه آزمون فقط شامل نمونههای خطادار بود، دقت آزمون برای هر فاز از ۸۵ درصد فراتر رفت. این نتیجه را نیز با شبیهسازی سیستم دوباسه با بار متعادل اعتبارسنجی کردند.
چرا یادگیری ماشین در سیستم قدرت کاربردیتر شده است
در گزارشی دیگر تأکید شده است که با گسترش کاربردهای یادگیری ماشین، رسیدگی به چالشهای پیچیده سیستم قدرت آسانتر شده است. روشهای سنتی از نظر محاسباتی چندان امیدبخش نیستند، زیرا ظرفیت محدودی برای مدیریت حجم عظیم دادهها دارند. این دادهها حتی میتوانند بخشهای بزرگی از مجموعهدادههای ناهمگن را در بر بگیرند. چنین دادههایی از واحدهای اندازهگیری مانند کنتورهای هوشمند و واحدهای اندازهگیری فازوری یا PMUها وارد میشوند.
این مطالعه بیان میکند که چندین الگوریتم یادگیری پیشرفته، کارآمد و هوشمند توسعه یافتهاند. هدف این الگوریتمها، بهبود دقت حل مسائل واقعی در حوزههای گوناگون است. از جمله این حوزهها میتوان به پایداری ولتاژ، مدیریت پخش بار و عیبیابی سامانه روتور اشاره کرد. همچنین، مطالعه نشان داد که روشهای طبقهبندی در یادگیری ماشین نظارتشده بیش از سایر روشها به کار میروند. این موضوع نشان میدهد که الگوریتمهای طبقهبندی برای بسیاری از مسائل سودمندی بیشتری دارند.
جمعبندی آن مطالعه روشن بود. با بهکارگیری یادگیری ماشین در مسائل مهندسی برق، موضوعات دشوار سادهتر میشوند. افزون بر این، نتایج بهدستآمده نیز دقیق و قابل اتکا هستند. این نکته برای کاربردهای حساس سیستم قدرت اهمیت زیادی دارد، زیرا تصمیمگیری نادرست در این حوزه میتواند پیامدهای گستردهای در بهرهبرداری ایجاد کند.
ارزیابی امنیت سیستم قدرت با مدلهای یادگیری ماشین
مطالعهای دیگر، روشهای یادگیری ماشین را برای ارزیابی امنیت سیستم قدرت ارائه کرد. این گزارش توضیح میدهد که شبکههای برق مدرن همچنان در برابر خاموشیهای گسترده آسیبپذیر هستند. همچنین، تأکید میکند که همه حالتهایی که به خاموشی بزرگ منجر میشوند، یکتا هستند. بنابراین، الگوریتمی وجود ندارد که بتواند حالتهای پیشاضطراری را بهصورت قطعی شناسایی کند. از سوی دیگر، روشهای عددی متعارف هزینه محاسباتی بالایی دارند. به همین دلیل، استفاده از آنها در ارزیابی امنیت برخط دشوار است.
در مقابل، روشهای یادگیری ماشین میتوانند رویکردی جایگزین ارائه دهند. دلیل این موضوع، توانایی آنها در تشخیص الگو، یادگیری و شناسایی سریع عبور احتمالی از مرزهای امنیتی است. این مطالعه تأکید کرد که در ده سال گذشته، رخدادهایی در آمریکای شمالی، اروپا و آسیا روی دادهاند. این رویدادها افزایش احتمال خاموشیهای بزرگ را بهروشنی نشان دادهاند. در نتیجه، باید پایش امنیت و کنترل سیستمهای قدرت را بهبود داد.
مقاله، روشی نو برای ارزیابی امنیت برخط با استفاده از تکنیکهای یادگیری ماشین معرفی کرد. در این روش، چندین تکنیک مانند شبکههای عصبی مصنوعی، ماشین بردار پشتیبان و درخت تصمیم را ابتدا بهصورت برخط آموزش میدهند. روش آموزش نیز بر پایه اعتبارسنجی متقابل بازنمونهگیری است. بازنمونهگیری از نمونههای آموزشی کمک میکند تشخیص دهیم آیا برای مقادیر پارامترهای تنظیمی مدل انتخاب نامناسبی انجام شده است یا نه. سپس، بر اساس عملکرد، بهترین مدل هر تکنیک را انتخاب میکنند.
برای کاربرد برخط، بهترین مدل از میان همه مدلهای یادگیری ماشین بهعنوان گزینه نهایی انتخاب میشود. این گزینه همان مدلی است که بهترین عملکرد را دارد. در صورت نیاز، مدل نهایی را بررسی و بهروزرسانی میکنند. هدف از این کار، لحاظ کردن دقیقترین تغییرات حالتهای جدید سیستم است. نتایج این پژوهش نشان داد که رویکرد پیشنهادی میتواند حالتهای بالقوه خطرناک را با دقت بالا شناسایی کند. همچنین، اگر لازم باشد، مدل نهایی میتواند برای فعالسازی سامانههای اضطراری و حفاظتی هشدار تولید کند.
یادگیری تقویتی برای کنترل سیستم قدرت
در مطالعهای دیگر، کاربرد یادگیری تقویتی در کنترل سیستمهای قدرت بررسی شد. این کار، علاوه بر معرفی ایده اصلی، برخی چالشهای کنترل سیستم قدرت را نیز توضیح داد. همچنین نشان داد که چگونه میتوان بخشی از این چالشها را با تکنیکهای یادگیری تقویتی برطرف کرد. پژوهشگران دشواریهای مرتبط با استفاده از روشهای RL در کنترل سیستم قدرت را نیز مطرح کردند. در کنار آن، راهبردهایی برای غلبه بر این دشواریها ارائه دادند. در این مطالعه، دو حالت یا دو مد از یادگیری تقویتی در نظر گرفته شد.
حالتهای پیادهسازی یادگیری تقویتی در سیستم قدرت
در کاربردهای یادگیری ماشین در سیستم قدرت، یادگیری تقویتی معمولاً در دو حالت اجرا میشود. هر یک از این حالتها، نحوه تعامل عامل با محیط را مشخص میکند. به همین دلیل، انتخاب حالت اجرا مستقیماً بر ایمنی، هزینه و سرعت توسعه اثر میگذارد.
حالت نخست، برخط است. در این حالت، عامل مستقیماً با سیستم قدرت واقعی تعامل میکند. یعنی وضعیتهای واقعی شبکه را میبیند و بر همان مبنا، عمل کنترلی صادر میکند.
حالت دوم، برونخط است. در این حالت، عامل با شبیهسازیِ مدلِ سیستم قدرت واقعی تعامل دارد. بنابراین بهجای شبکه واقعی، روی یک مدل محاسباتی آموزش میبیند و همانجا ارزیابی میشود.
مطالعههای موردی روی سیستم چهارماشینه
برای نشان دادن ارزش عملی این رویکرد، دو مطالعه موردی روی یک مدل سیستم قدرت چهارماشینه ارائه شدهاند. هر دو مطالعه بر یادگیری تقویتی تکیه دارند. با این حال، یکی در حالت برونخط انجام شده و دیگری در حالت برخط بررسی شده است.
در مطالعه نخست، پژوهشگران طراحی کنترلکننده ترمز دینامیکی را مدنظر قرار دادهاند. آنها این کنترلکننده را با استفاده از الگوریتمهای یادگیری تقویتی و در حالت برونخط طراحی میکنند. در نتیجه، فرایند یادگیری و تنظیم اولیه روی شبیهسازی انجام میشود، نه روی شبکه واقعی.
این انتخاب اهمیت زیادی دارد؛ زیرا ترمز دینامیکی با ناپایداریهای گذرا و پاسخهای سریع سروکار دارد. بنابراین، اگر راهبردهای هنوز آموزشندیده را مستقیماً روی سیستم واقعی آزمایش کنیم، ریسک بالایی ایجاد میشود.
مطالعه نخست: طراحی کنترلکننده ترمز دینامیکی در حالت برونخط
در این مطالعه، الگوریتم یادگیری تقویتی با مدل سیستم چهارماشینه کار میکند. هدف این است که یک سیاست کنترلی مناسب برای عملکرد ترمز دینامیکی پیدا شود. به این ترتیب، عامل یاد میگیرد در شرایط مختلف بهرهبرداری چه تصمیمی بگیرد تا پاسخ دینامیکی بهبود پیدا کند.
مهمترین مزیت حالت برونخط، امکان تکرار بسیار زیاد سناریوهاست. افزون بر این، میتوان اغتشاشها، تغییر پارامترها و شرایط کاری گوناگون را بدون تهدید شبکه واقعی بررسی کرد. این ویژگی، توسعه کنترلکننده را هم سریعتر میکند و هم ایمنتر.
از دید مهندسی، این رویکرد برای تجهیزاتی بسیار مفید است که رفتارشان در شرایط گذرا حساسیت بالایی دارد. کنترلکنندهای که ابتدا در شبیهسازی آموزش دیده باشد، معمولاً پایه مناسبتری برای پیادهسازی نهایی فراهم میکند.
مطالعه دوم: کنترل TCSC در حالت برخط
مطالعه دوم به روشهای یادگیری تقویتی در حالت برخط میپردازد. در اینجا، تمرکز کاربرد بر کنترل خازن سری کنترلشده با تریستور یا TCSC است. هدف اصلی نیز میرا کردن نوسانهای سیستم قدرت است.
در این حالت، عامل یادگیری با سیستم واقعی در تعامل است. یعنی دادههای اندازهگیریشده را دریافت میکند و بر همان اساس، فرمان کنترلی TCSC را تولید میکند. سپس اثر تصمیم خود را در رفتار واقعی شبکه میبیند.
TCSC یکی از تجهیزات مهم کنترل انعطافپذیر در سیستم انتقال است. این تجهیز میتواند مشخصه معادل خط را تغییر دهد. در نتیجه، برای بهبود میرایی نوسانها و ارتقای پایداری دینامیکی کاربرد بسیار زیادی دارد.
وقتی یادگیری تقویتی را در حالت برخط روی TCSC اعمال میکنیم، کنترلکننده میتواند خود را با شرایط واقعی سازگار کند. این قابلیت در شبکههایی که شرایط بهرهبرداری در آنها پیوسته تغییر میکند، اهمیت زیادی دارد.
جمعبندی فنی این بخش
این دو مطالعه موردی نشان میدهند که یادگیری تقویتی هم در محیط برونخط و هم در محیط برخط میتواند مفید باشد. در حالت برونخط، تمرکز بر طراحی ایمن و آموزش در شبیهسازی است. در حالت برخط، تمرکز به سازگاری مستقیم با رفتار واقعی سیستم معطوف میشود.
بر این اساس، روشهای RL میتوانند برای مسائل کنترلی در سیستم قدرت، گزینهای جالب و قابلتوجه باشند؛ بهویژه وقتی هدف، بهبود عملکرد دینامیکی، افزایش میرایی نوسانها و واکنش هوشمند در شرایط متغیر باشد.
در عمل، موفقیت این روشها به کیفیت مدل، دقت اندازهگیری، تعریف مناسب پاداش و رعایت قیود ایمنی بستگی دارد. با این حال، این مسیر نشان میدهد یادگیری ماشین در سیستم قدرت از تحلیل داده فراتر رفته است. این فناوری اکنون به طراحی و اجرای کنترلهای پیشرفته نیز وارد شده است.
پرسشهای متداول
یادگیری ماشین در سیستم قدرت دقیقاً چه تفاوتی با تحلیل سنتی دارد؟
تحلیل سنتی بیشتر بر مدلهای صریح فیزیکی و محاسبات از پیش تعریفشده تکیه دارد، اما یادگیری ماشین از دادههای گذشته یا شبیهسازیشده الگو میآموزد و برای پیشبینی یا تصمیمگیری به کار میرود. در مسائل پیچیده و بلادرنگ، این روش میتواند سریعتر و انعطافپذیرتر باشد.
چرا دادههای سیستم قدرت را جزو دادههای عظیم محسوب میکنند؟
چون دادهها از منابع متعدد مانند اسکادا، تجهیزات پایش، پستها و شبیهسازیها میآیند و هم از نظر حجم و هم از نظر سرعت تولید و پیچیدگی، زیاد هستند. این دادهها اغلب باید بهصورت بلادرنگ تحلیل شوند.
کنترل پیشگیرانه و کنترل اضطراری چه فرقی دارند؟
کنترل پیشگیرانه پیش از رخداد و معمولاً توسط اپراتور انجام میشود تا شبکه در وضعیت امن باقی بماند. کنترل اضطراری پس از وقوع اغتشاش و غالباً بهصورت خودکار اجرا میشود تا پیامدهای ناپایداری کاهش یابد.
چرا در آموزش مدلهای یادگیری ماشین از شبیهسازی زیاد استفاده میشود؟
زیرا بسیاری از رخدادهای بحرانی در دادههای واقعی کمتکرار یا خطرناکاند و نمیتوان برای جمعآوری آنها منتظر ماند. شبیهسازی عددی امکان تولید سناریوهای متنوع و حتی چند هزار حالت مختلف را برای آموزش و ارزیابی مدل فراهم میکند.
آیا یادگیری ماشین میتواند جای مهندس سیستم قدرت را بگیرد؟
خیر. این ابزار زمانی بهترین نتیجه را میدهد که با دانش مهندسی قدرت ترکیب شود. انتخاب متغیرها، تفسیر نتایج، اعتبارسنجی مدل و تصمیم نهایی همچنان به قضاوت مهندسی نیاز دارد.
